海洋牧场是基于海洋生态学原理和现代海洋工程技术,充分利用自然生产力在特定海域科学培育和管理渔业资源而形成的人工渔场[1],其建设在增殖放流、生态修复及生态旅游等方面发挥着重要作用[2]。近年来,大力发展海洋牧场产业,推动海洋养殖向信息化、智能化发展是落实党和国家海洋强国战略的重要举措[3],其中,对水下生物的精准检测是实现海洋牧场智能化管理和可持续发展的关键。
传统的人工采样与监测方式不仅效率低,而且易对海洋牧场的生态系统造成干扰,因此,研究者逐渐探索高效、非侵入式的水下生物检测技术。在早期的研究中[4-5],水下目标检测任务主要依赖人工设计特征(如形状、颜色和纹理等),并结合传统分类器实现识别与分类。尽管后续研究通过多特征融合与算法优化取得了一定的进展[6],但这类方法依然存在特征表达能力有限、环境适应性差和检测效率低的问题,在水下目标检测任务中表现不佳[7]。近年来,随着深度学习的迅速发展,基于卷积神经网络(convolutional neural network,CNN)的检测方法逐渐成为主流[8],该方法通常可分为两类:一类是两阶段检测算法,如R-CNN[9]、Faster R-CNN[10]、MR-CNN[11]等,这类算法通常结合FPN[12]等特征融合组件提升多尺度检测能力,虽然检测精度较高,但网络结构复杂、计算量大,难以满足实时检测的需求;另一类是以YOLO系列为代表的单阶段检测算法[13],该类方法在保持较高精度的同时,还具有网络结构轻量、检测速度快的优势。
随着YOLO系列的不断发展,其在水下目标检测领域也得到广泛应用。Al Muksit等[14]基于YOLOv3提出了YOLO-Fish-1和YOLO-Fish-2模型,并分别通过改进上采样和引入空间金字塔结构,提升了模型的检测精度。刘萍等[15]在YOLOv5预处理阶段集成暗通道先验算法(dark channel prior,DCP),减轻了图像颜色失真对检测过程的干扰。Liu等[16]提出的YOLO-Waternet结合CRFPN特征融合网络,在一定程度上降低了目标密集与遮挡引起的漏检情况。陈郁隈等[17]在YOLOv8模型的基础上引入可变形卷积DCNv4提取深层特征图中的鱼类细微特征并采用Shape-IoU算法优化鱼类边界框位置,在自建的水下鱼类图像数据集上准确率达到95.1%,但不适合用于水下小尺寸及密集生物检测。赵晨等[18]针对模型参数量太多与计算量过大的问题,为YOLOv7模型重新设计轻量级网络结构,并采用P-ELAN和P-ELAN-W模块,改进后的模型参数量和计算量分别减少了75.9%和30.7%。赵煜等[19]通过应用FastNet主干网络、融合DCNv2卷积、替换DySample上采样和V7DownSample模块,实现了对河蟹各部位的高效检测,在自建的数据集上,平均精度均值达到96.5%,但不利于部署在水下任务中。王芳等[20]针对YOLOv8s模型在水下目标检测任务中性能不足的问题,在模型Backbone和Neck部位分别引入BCAM和BiFormer注意力模块以增强模型的特征提取和融合能力,平均精度均值达到88.9%,但参数量提高了24.3%,不利于模型在边缘设备的部署。Qu等[21]提出的YOLOv8-LA模型引入轻量级高效部分卷积(LEPC)、AP-FasterNet特征提取模块与CARAFE上采样机制,降低了参数量与计算量,但模型精度提升有限。李响等[22]在YOLOv8主干网络引入FasterNet轻量化网络结构减少模型参数量并在网络关键部位引入BiFormer注意力机制提升特征提取能力,在自建的贝壳数据集准确率达到95.5%,但不利于部署在水下任务中。刘侦龙等[23]在YOLOv10中加入MECAS注意力模块并引入可切换空洞卷积SAConv,准确率达到85.7%,但在复杂水下环境中模型检测性能明显下降。
现有改进模型在清晰水下环境和非密集水下生物目标场景中取得了较好的识别效果,但在海洋牧场复杂水下环境下仍存在较多的错检与漏检问题。其原因主要包括:在复杂水下环境中,目标姿态变化、水体光照不均及背景干扰常导致目标出现特征差异;水体对光的散射和吸收会导致目标边缘模糊、纹理细节丢失,且会在图像中引入类雾状均匀噪声,进一步削弱目标特征;现有模型对水下小尺寸及密集目标(如扇贝、鱼群等)的特征学习能力仍显不足。因此,研究兼顾检测精度和检测速度的水下生物目标检测方法,对提升海洋牧场水下生物管理效率和促进水产养殖业的可持续发展具有重要意义。
针对以上问题,本文提出一种YOLO-DEA水下生物目标检测模型,其以YOLOv13n为基础模型,通过引入动态卷积(Dynamic Convolution,DynamicConv)替换深度可分离卷积(DS-Conv),构建增强型混合通道注意力机制(enhanced mixed channel attention,EMCA),设计自适应阈值焦点损失函数(adaptive threshold focal loss,ATFL)。DynamicConv通过多专家卷积核与动态权重融合机制,使卷积核参数能够根据输入特征自适应调整,增强卷积核的特征适应能力;EMCA通过双池化融合策略,结合全局平均与最大池化自适应增强或抑制各通道特征响应,抑制环境冗余干扰、强化目标特征响应;ATFL根据训练过程中的整体置信度动态调整损失权重,强化模型对小尺寸及密集目标的学习能力。通过在RUOD和URPC 2020数据集上进行试验分析,提出的YOLO-DEA模型能够有效应对水体能见度低、水下生物形态多变且遮挡情况复杂等问题,在海洋牧场水下生物目标检测任务中有着优越的检测精度与检测速度。
1 数据集与模型基础
1.1 数据集来源
为验证模型的检测性能与泛化能力,本文使用RUOD和URPC 2020两个公开数据集作为试验数据。
RUOD[24]是一个海洋水下复杂环境的高质量目标检测基准数据集,共包含14 000张高分辨率图像,被划分为9 800张训练图像和4 200张验证图像,共计74 903个标注实例,涵盖10类典型水下生物:鱼类(fish)、海胆(echinus)、珊瑚(corals)、海星(starfish)、海参(sea cucumber)、扇贝(scallop)、潜水员(diver)、乌贼(cuttlefish)、海龟(turtle)和水母(jellyfish)。RUOD的部分数据样本如图1所示。
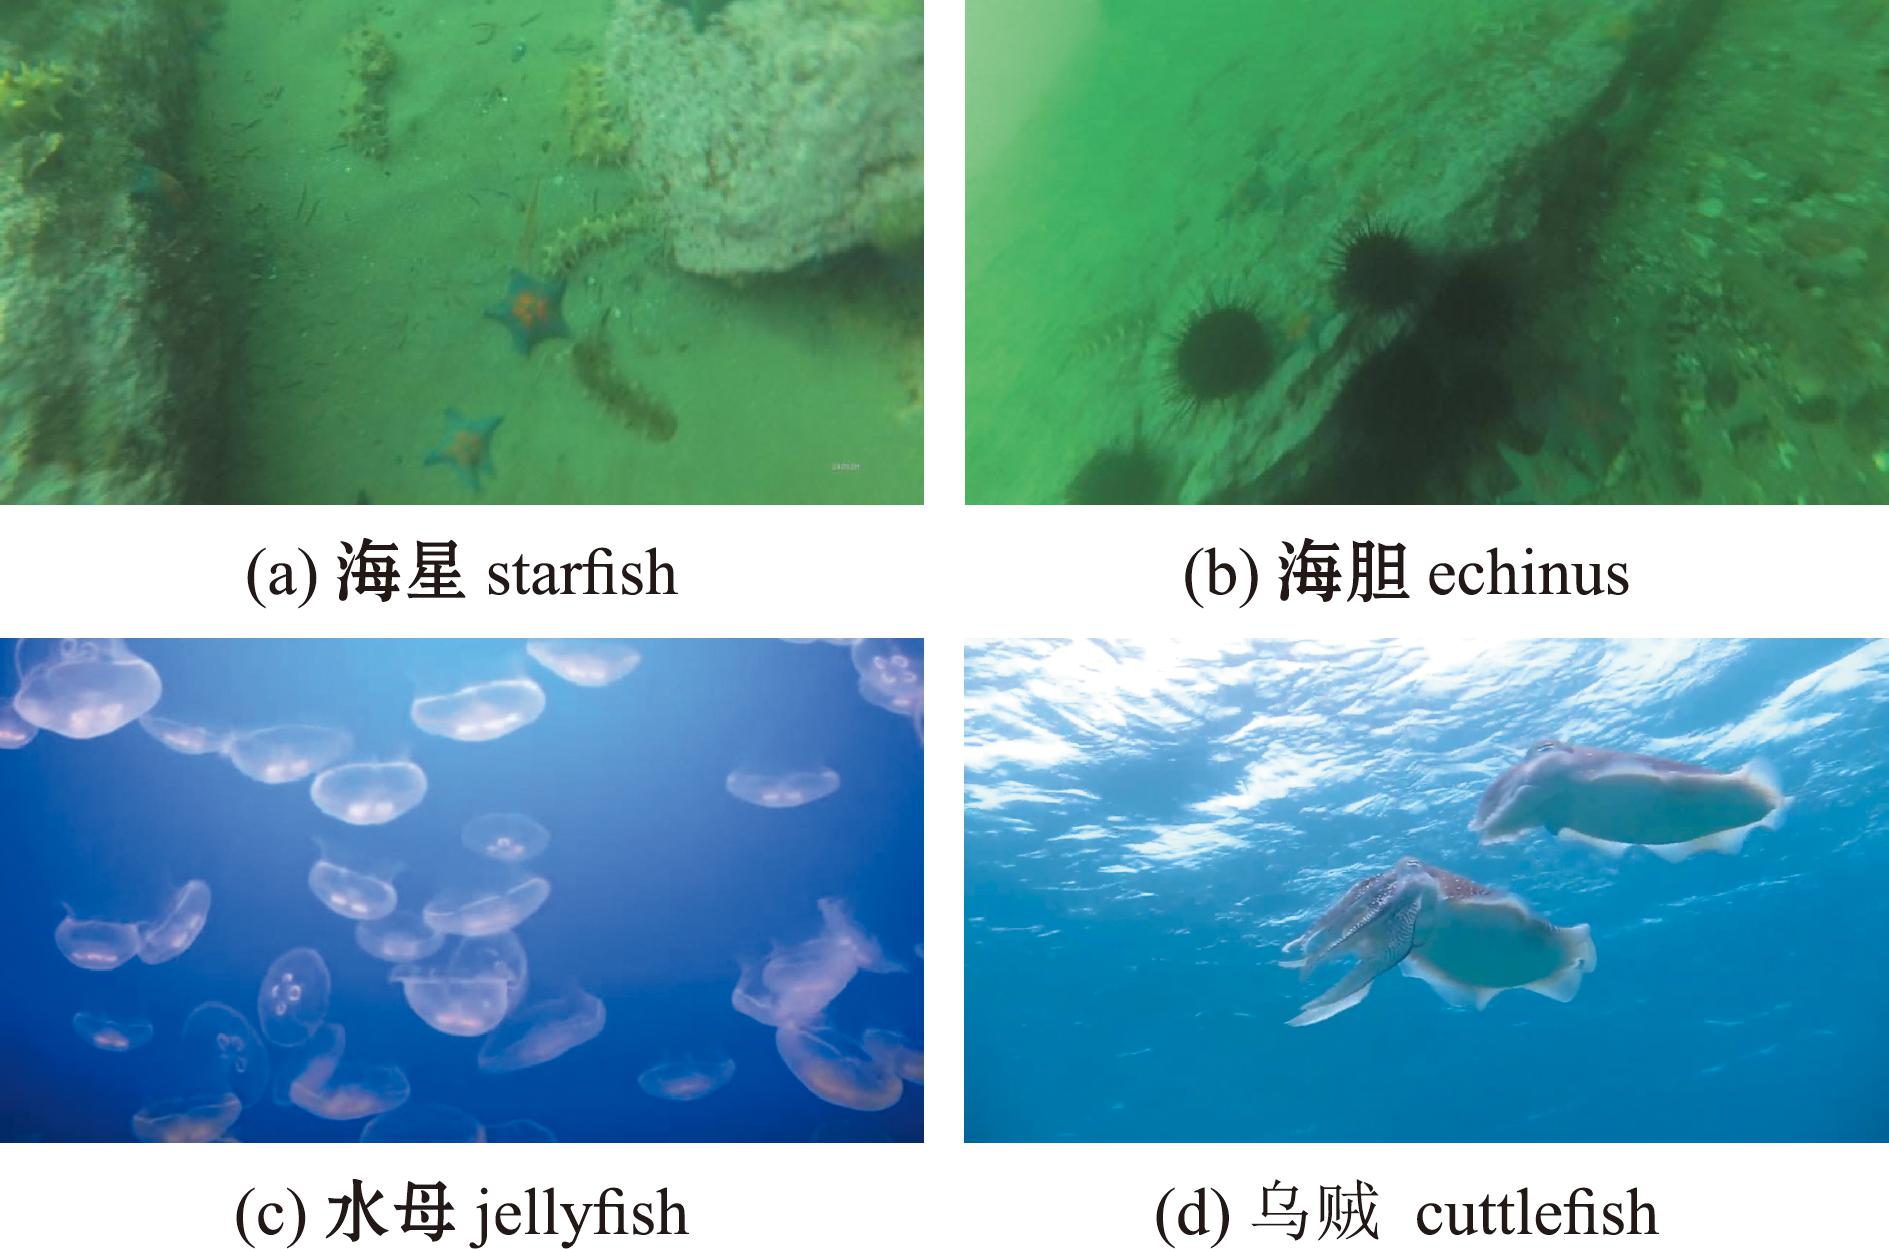
图1 RUOD数据集样本图
Fig.1 Sample images from the RUOD dataset
URPC 2020数据集是水下目标检测领域常用的基准数据集之一,共包含7 543张水下图像,被划分为5 543张训练图像、800张验证图像、1 200张测试图像。涵盖4类典型水下生物:海参、海胆、扇贝和海星。URPC 2020数据集的部分数据样本如图2所示。
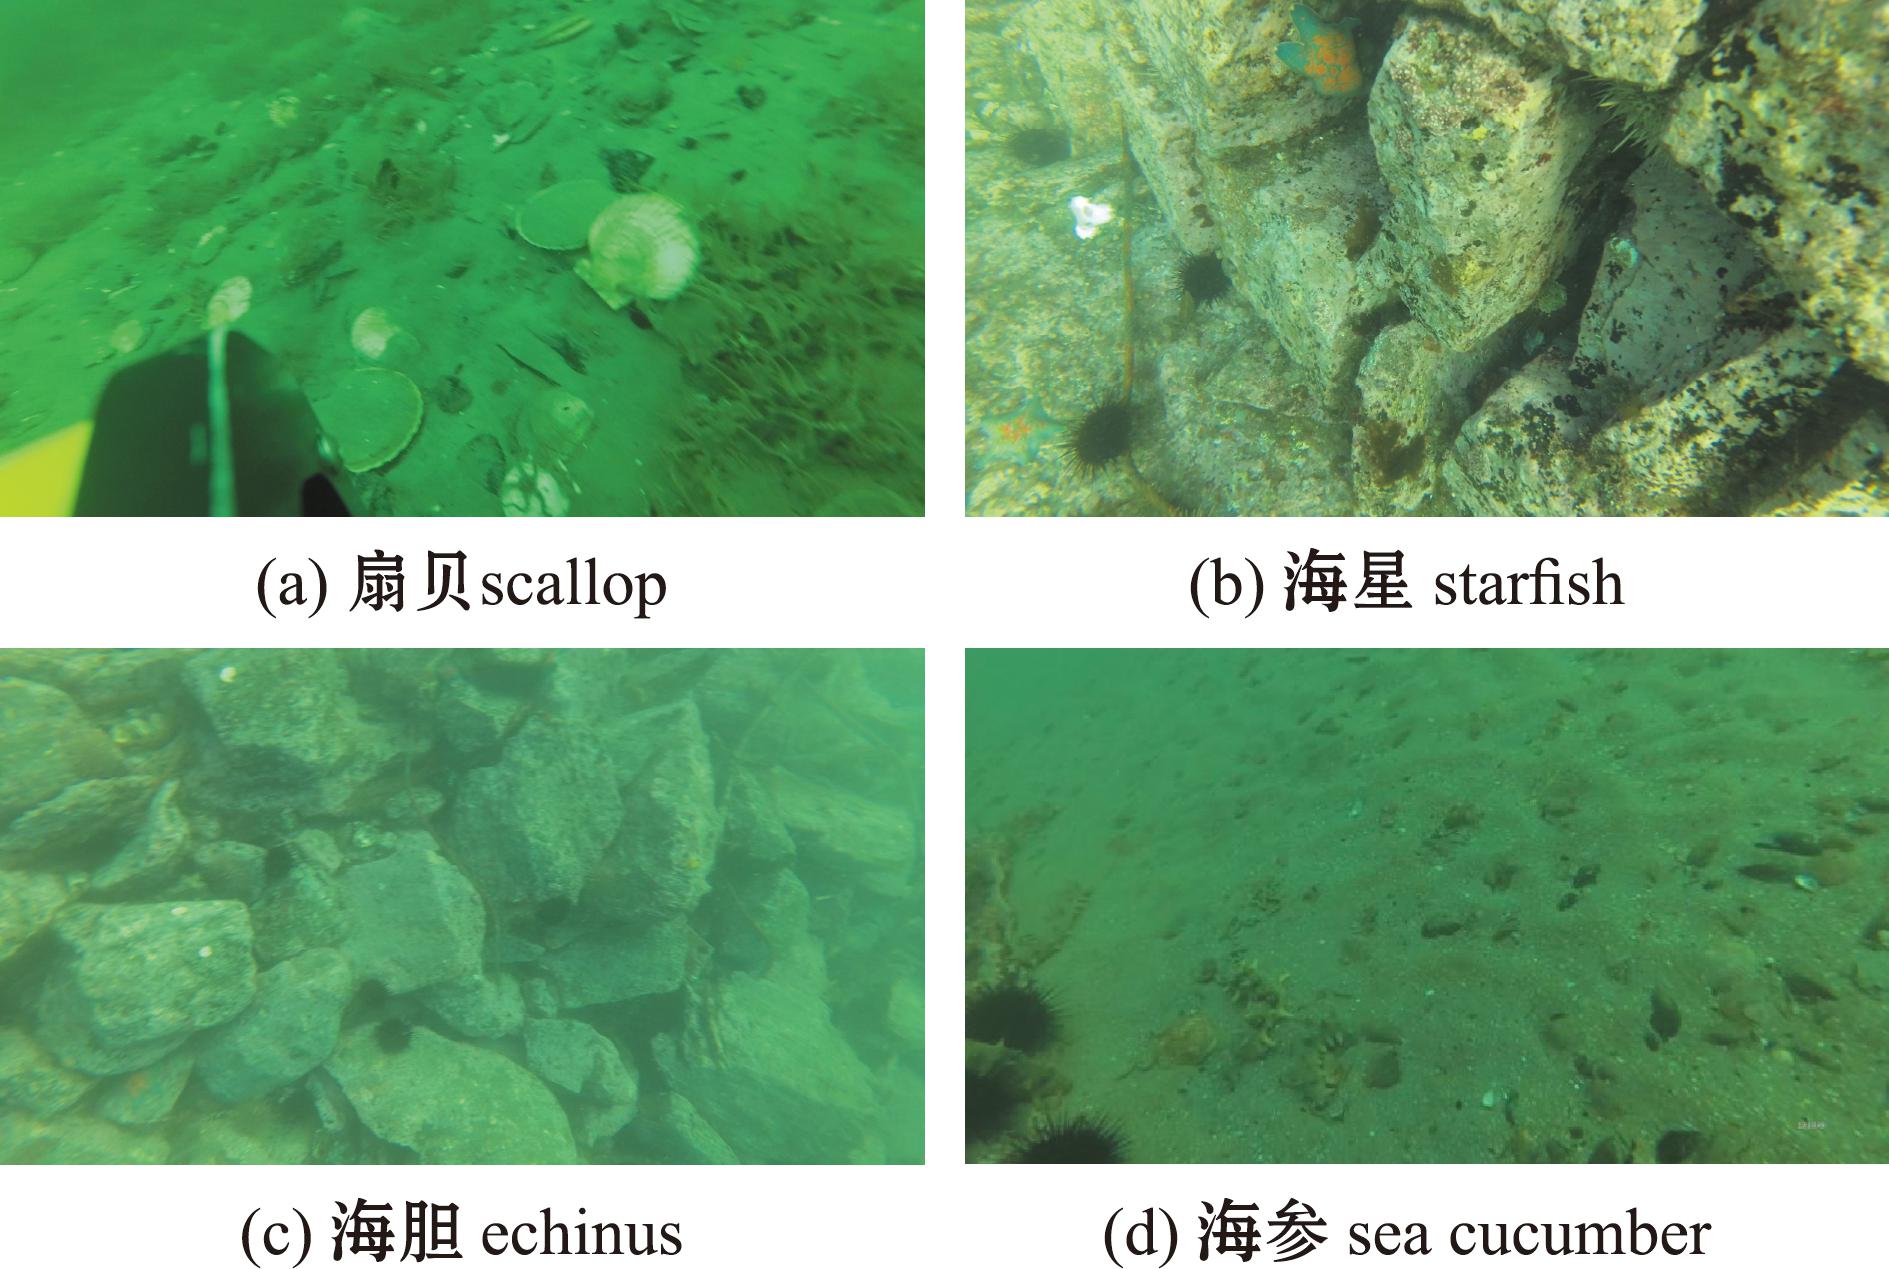
图2 URPC2020数据集样本图
Fig.2 Sample images from the URPC2020 dataset
1.2 YOLOv13模型
本文选择YOLOv13n作为基础模型,主要基于以下考量:YOLOv13[25]作为近年来提出的轻量化YOLO系列模型,在继承YOLO系列实时检测优点的基础上,在网络模型中引入了基于超图的自适应相关性增强机制(hypergraph-based adaptive correlation enhancement,HyperACE)和全流程“聚合-分发”策略(full-pipeline aggregation and distribution,FullPAD)。其中,HyperACE模块在传统的超图基础上创新引入可学习超边生成的策略,将多尺度特征图的像素视为超图顶点,自适应地学习并构建超边关系,从而动态捕获不同特征顶点间潜在的高阶关联;FullPAD打破了传统“Backbone-Neck-Head”的单向特征传递范式,设计了3条独立的特征流通路径(主干与颈部连接层、颈部内部层、颈部与头部连接层),将HyperACE聚合后的多尺度特征分别发送到模型网络中的不同阶段,从而实现了细粒度信息交互与全流程表征协同。YOLOv13在精度与训练速度间取得了良好平衡,这为在有限复杂度预算内集成定制化模块、实现性能提升提供了良好的基础。
2 YOLO-DEA模型
为了充分发挥YOLOv13模型的结构优势,提升其在海洋牧场水下生物目标检测任务中的适应性。本文以YOLOv13n为基础模型,提出了改进的YOLO-DEA(图3)。主要从特征提取、注意力建模和损失函数三个方面进行优化:在Backbone与Neck中的特征提取与特征融合模块中,将原有DS-Conv替换为DynamicConv,而检测头中的预测卷积保持不变,以在保证推理稳定性的同时提升特征表达能力;EMCA模块部署于检测头的多尺度特征分支中,用于增强高层语义特征的判别性,从而在不显著增加计算量的前提下提升检测精度;为提高模型对密集遮挡等难以检测目标的学习能力,采用ATFL自适应阈值焦点损失函数,改进后的网络结构如图3所示。
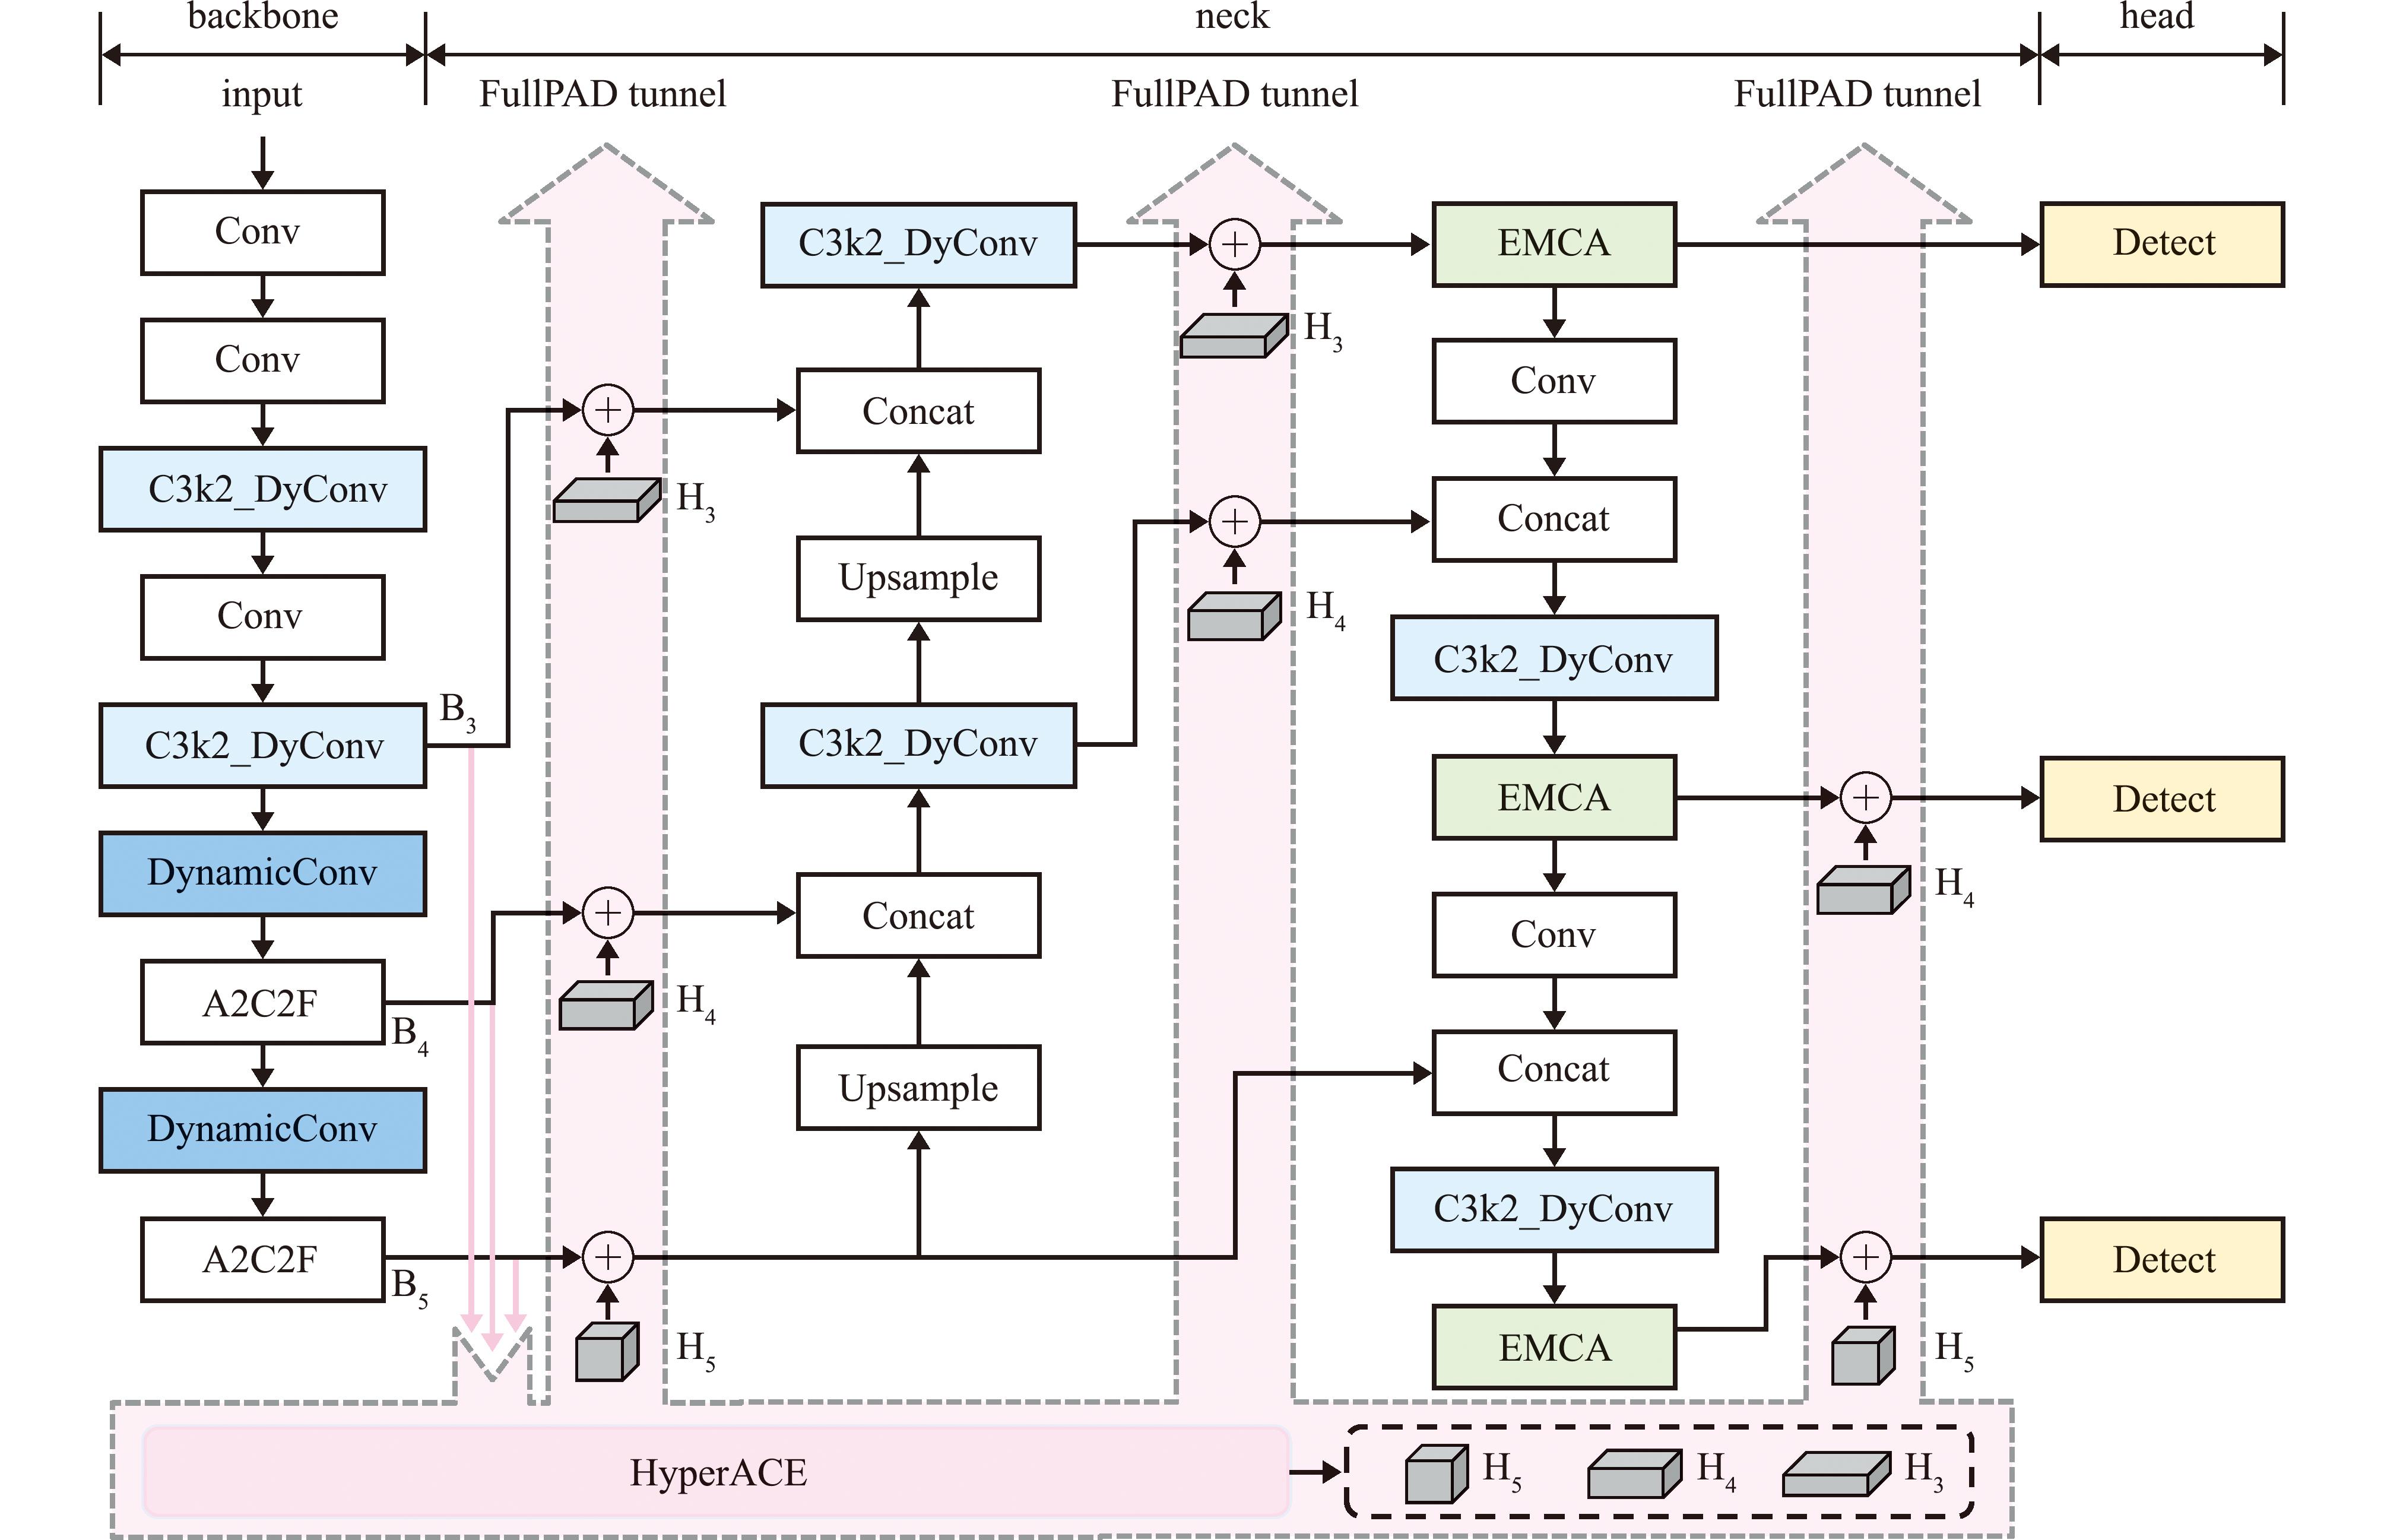
HyperACE—YOLOv13n模型基于超图的自适应相关性增强机制;FullPAD Tunnel—全流程聚合与分发隧道;C3k2DyConv、DynamicConv—动态卷积内的卷积操作;EMCA—增强型混合通道注意力;Conv—卷积操作;A2C2F—特征增强模块;Concat—通道数相加函数;Upsample—上采样操作。
HyperACE—hypergraph-based adaptive correlation enhancement module in YOLOv13n;FullPAD Tunnel—full-process aggregation and distribution;C3k2DyConv,DynamicConv—convolution operations within the DynamicConv module;EMCA—enhanced mixed-channel attention;Conv—convolution;A2C2F a feature enhancement module;Concat—channel concatenation;Upsample—upsampling.
图3 YOLO-DEA模型网络结构图
Fig.3 Architecture of the YOLO-DEA model
2.1 DynamicConv动态卷积
水下生物目标(如游动的鱼、虾等)形态与尺度并非固定不变,而是受水流动力与自身行为影响发生连续的非刚性形变,即使是同一类别,其特征也可能存在较大差异。深度可分离卷积(DS-Conv)使用固定的卷积核参数,对此类动态变化的特征捕捉能力有限,为此,本文使用DynamicConv动态卷积,针对每个输入样本,动态生成与之相适应的卷积核权重。通过多专家卷积核与动态权重融合机制,卷积核参数能够根据输入特征自适应调整,从而提升模型对水下目标特征变化(如鱼身的弯曲、鳍的摆动等)的适应能力,MoE(mixture of experts)层如图4所示。
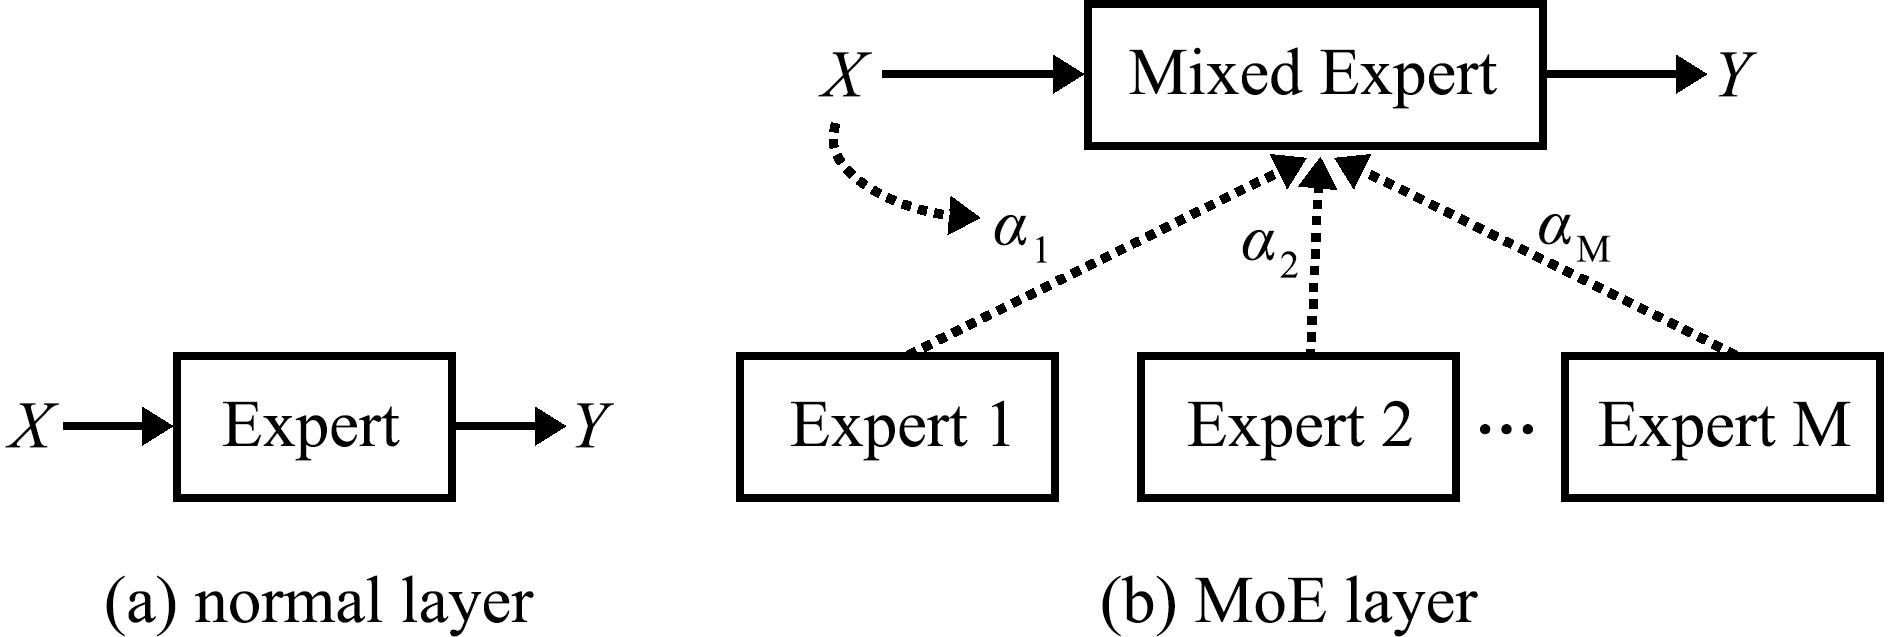
图4 MoE参数增强层
Fig.4 parameter enhancement via MoE layer
在MoE层中,多个专家卷积核的输出与动态系数加权求和,生成增强型卷积核。设有M个专家卷积核{W1,W2,…,WM},其对应的动态系数为{α1,α2,…,αM},则每个样本的增强型卷积核为
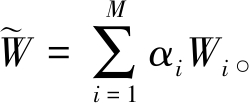
(1)
式中:Wi为第i个专家的卷积核;αi为与输入特征相关的动态系数; 为增强后的卷积核。
而动态卷积系数α的生成如下,首先对输入特征X做全局平均池化(GAP),将空间信息压缩为通道特征向量z,然后将向量z输入两层轻量级全连接网络(MLP),通过Sigmoid激活后得到每个专家卷积核的动态系数α,其计算公式为
α=σ{MLP[GAP(X)]}。
(2)
DynamicConv模块最终的卷积输出为输入特征与增强型卷积核的卷积,计算公式为
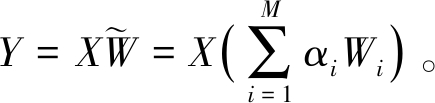
(3)
式中:Y为输出特征;X为输入特征;为增强后的卷积核。
2.2 EMCA注意力机制
针对复杂水下环境中背景冗余信息丰富、目标特征易被弱化的问题,本文引入注意力机制以强化目标特征响应。考虑到水下计算平台通常资源受限,本文选择高效的轻量化通道注意力机制(efficient channel attention,ECA)[26]进行改进,提出了一种增强型混合通道注意力机制(EMCA)。
ECA是一种高效通道注意力机制,其核心优势在于轻量化且性能提升显著。该机制通过避免降维和局部跨通道交互,在几乎不增加模型参数的情况下提升了特征判别力[26]。ECA模块利用全局平均池化提取每个通道的全局信息后,通过一维卷积建模相邻通道的依赖关系,生成通道注意力,避免了传统注意力机制因降维导致的信息损失[26]。设输入特征为X,其整体过程可表示为
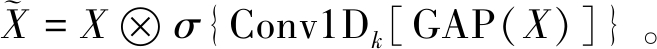
(4)
式中:GAP表示全局平均池化;Conv1Dk表示卷积核大小为k的一维卷积操作;σ表示Sigmoid激活函数;⊗表示逐通道加权。
然而,在复杂水下环境中,水体对光的散射和吸收会导致目标边缘模糊、纹理细节丢失,且会在图像中引入类雾状均匀噪声,进一步削弱目标特征,仅使用全局平均池化(GAP)会稀释部分目标的局部显著特征(如生物眼部或鳞片高光)。为此,本文设计了EMCA注意力机制,该模块在通道维度上采用分组建模策略,首先将输入特征按通道划分为若干组,并分别进行全局平均池化与全局最大池化,以综合刻画不同通道组的全局响应特性。随后,采用大小为3的一维卷积在通道维度上建模局部通道依赖关系,并通过Sigmoid函数生成通道权重。最终,注意力权重以逐通道乘法的方式对原始特征进行重标定,从而增强关键通道特征、抑制冗余背景信息。EMCA结构如图5所示。
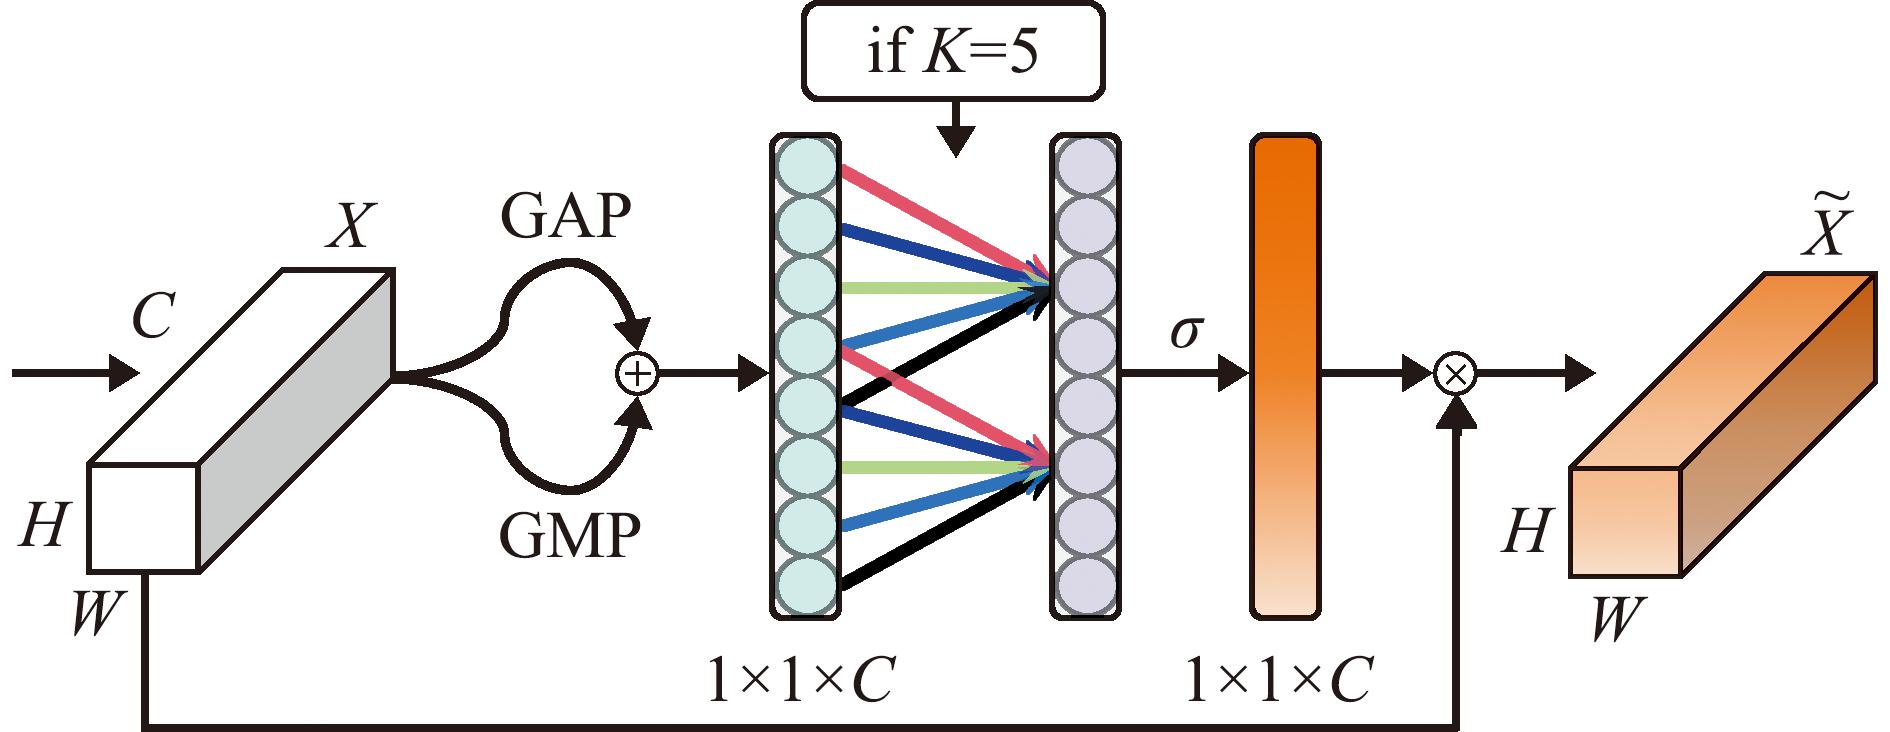
图5 EMCA结构
Fig.5 EMCA structure
设输入特征为X,对X分别进行全局平均池化(GAP)和全局最大池化(GMP),并将结果逐元素相加获得融合特征,公式为
Y=GAP(X)⊕GMP(X)。
(5)
式中:⊕表示逐元素相加;GAP(·)表示提取通道的全局统计信息;GMP(·)表示提取通道的显著响应信息。
融合后的通道描述向量Y在维度调整后,经过一维卷积进行局部通道交互建模,公式为
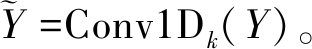
(6)
式中:k表示卷积核大小(k=3);用于建模相邻通道之间的局部依赖关系。
随后, 通过Sigmoid激活生成通道注意力权重,公式为
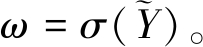
(7)
最后将输入特征X进行逐通道加权,输出特征与输入特征保持相同尺寸,公式为
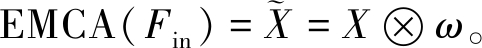
(8)
2.3 ATFL损失函数
在水下生物目标检测任务中,由于受到水体浑浊、光照衰减及目标密集遮挡等因素影响,小尺寸目标(如扇贝、鱼群等)往往具有较低的检测置信度,模型在训练过程中对该类样本的学习能力不足。为此,本文设计了自适应阈值焦点损失函数(ATFL),通过引入基于预测置信度的动态调制因子,对样本损失进行自适应加权,从而在保证高置信度样本稳定训练的同时,增强模型对低置信度样本的学习能力。
设第i个样本的网络输出logit为xi,真实标签为yi∈{0,1},其预测概率为pi=σ(xi),则样本预测概率定义为
pt,i=yipi+(1-yi)(1-pi)。
(9)
在一个批次内,对所有样本的pt,i取平均值,得到当前批次的置信度,其计算公式为
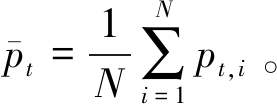
(10)
式中:N表示当前批次的样本总数; 反映模型在当前训练阶段对真实类别的整体预测置信水平。
为抑制不同批次之间置信度波动对训练稳定性的影响,采用指数滑动平均(exponential moving average,EMA)对批次置信度进行平滑更新:
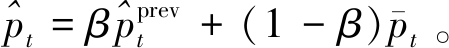
(11)
式中: 为平滑后的置信度估计值;
 为上一批次的值;β表示平滑系数。训练初始阶段将初始化为当前批次的

基于平滑后的批次置信度,定义自适应指数γadaptive,用于抑制高置信度样本产生过大的梯度,公式为
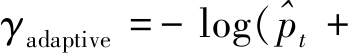
 )。
(12)
式中:=10-8用于保证数值稳定。
此后,根据不同置信度阈值计算动态调制因子f(pt)。当批次置信度较高时,采用平滑的指数抑制策略以维持训练稳定;当批次置信度较低时,通过增大调制指数放大梯度,整体过程表示为
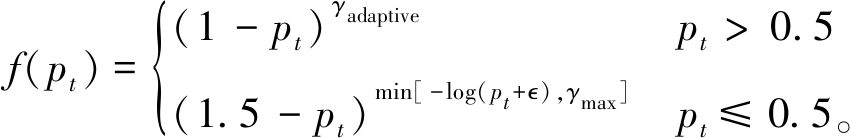
(13)
式中:γmax为调制系数上限,用以限制低置信度样本的最大权重。
最后,将动态调制因子与基础BCE损失逐元素相乘,得到ATFL损失,计算公式为
LATFL=f(pt)⊙LBCE(x,y)。
(14)
式中:⊙表示逐元素相乘;LBCE(x,y)表示标准二元交叉熵损失。
3 结果与分析
3.1 试验环境与评价指标
3.1.1 试验平台 本研究平台所用操作系统为64位Windows 11,CPU型号为Intel Core Ultra7 265K,GPU型号为NVIDIA GeForce RTX 5070 Ti。编程语言为Python 3.11,深度学习框架为PyTorch 2.7.1及CUDA12.8。本研究使用YOLOv13n作为基础模型,并在该模型基础上进行改进。
3.1.2 模型训练 在本研究模型训练时,图像分辨率统一转换为640×640。优化器为SGD,初始学习率为0.01,动量系数为0.937,权重衰减系数为0.000 5,批次大小(batch-size)为16,训练周期(epoch)为200。
3.1.3 模型评估指标 本文采用精确率(precision)、召回率(recall)、平均精度均值(mean average precision,mAP)、帧率(frames per second,FPS)、计算量(computation)和模型大小(model size)作为评价指标。
3.2 不同注意力机制对比试验
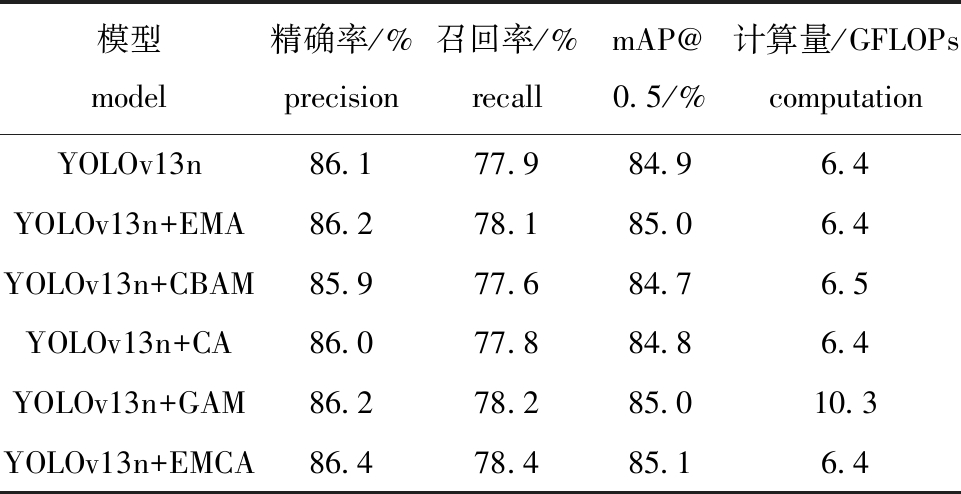
为验证EMCA注意力机制在海洋牧场水下生物目标检测任务中的适用性,本研究基于RUOD数据集,将其与高效多尺度注意力机制(efficient multi-scale attention,EMA)[27]、卷积块注意力机制(convolutional block attention module,CBAM)[28]、坐标注意力机制(coordinate attention,CA)[29]、全局注意力机制(global attention mechanism,GAM)[30]进行对比试验(表1)。从表1可见,CBAM与CA均未提升mAP@0.5,GAM虽略微提升mAP@0.5,但使模型计算量增加了60.9%,而EMCA在保持模型轻量化的同时,实现了最高的mAP@0.5,说明其在水下目标检测任务中能够有效聚焦目标特征,抑制复杂背景干扰。
表1 不同注意力机制对比
Tab.1 Comparison of different attention mechanisms
模型model精确率/%precision召回率/%recallmAP@0.5/%计算量/GFLOPscomputationYOLOv13n86.177.984.96.4YOLOv13n+EMA86.278.185.06.4YOLOv13n+CBAM85.977.684.76.5YOLOv13n+CA86.077.884.86.4YOLOv13n+GAM86.278.285.010.3YOLOv13n+EMCA86.478.485.16.4
3.3 ATFL的必要性分析
为了提升小尺寸及低置信度目标的检测精度,本文提出ATFL,与传统Focal Loss在RUOD数据集上进行对比试验,结果见表2。
表2 使用ATFL与Focal Loss的模型性能对比
Tab.2 Performance comparison of models using ATFL and Focal Loss
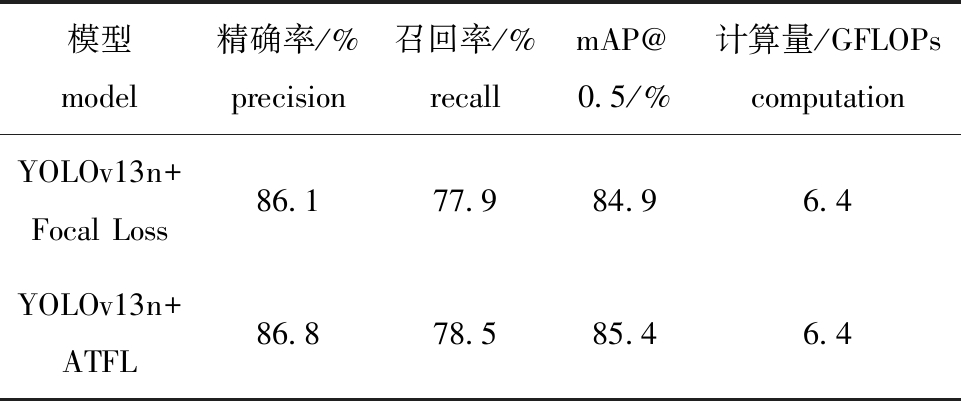
模型model精确率/%precision召回率/%recallmAP@0.5/%计算量/GFLOPscomputationYOLOv13n+Focal Loss86.177.984.96.4YOLOv13n+ATFL86.878.585.46.4
从表2可见,ATFL相比Focal Loss的mAP@0.5提升了0.5%,在保持实时性的前提下增强了模型对低置信度样本的学习能力,其动态调制因子可在训练过程中自适应调节样本贡献,更适合复杂水下环境的目标检测任务。
3.4 模型训练过程可视化分析
为直观展示YOLO-DEA与YOLOv13n的训练性能对比,本研究绘制了精确率和平均精度均值在训练过程中的变化曲线,如图6所示。从图6可见,YOLO-DEA 收敛速度更快,精度更高,验证了改进方法的有效性。
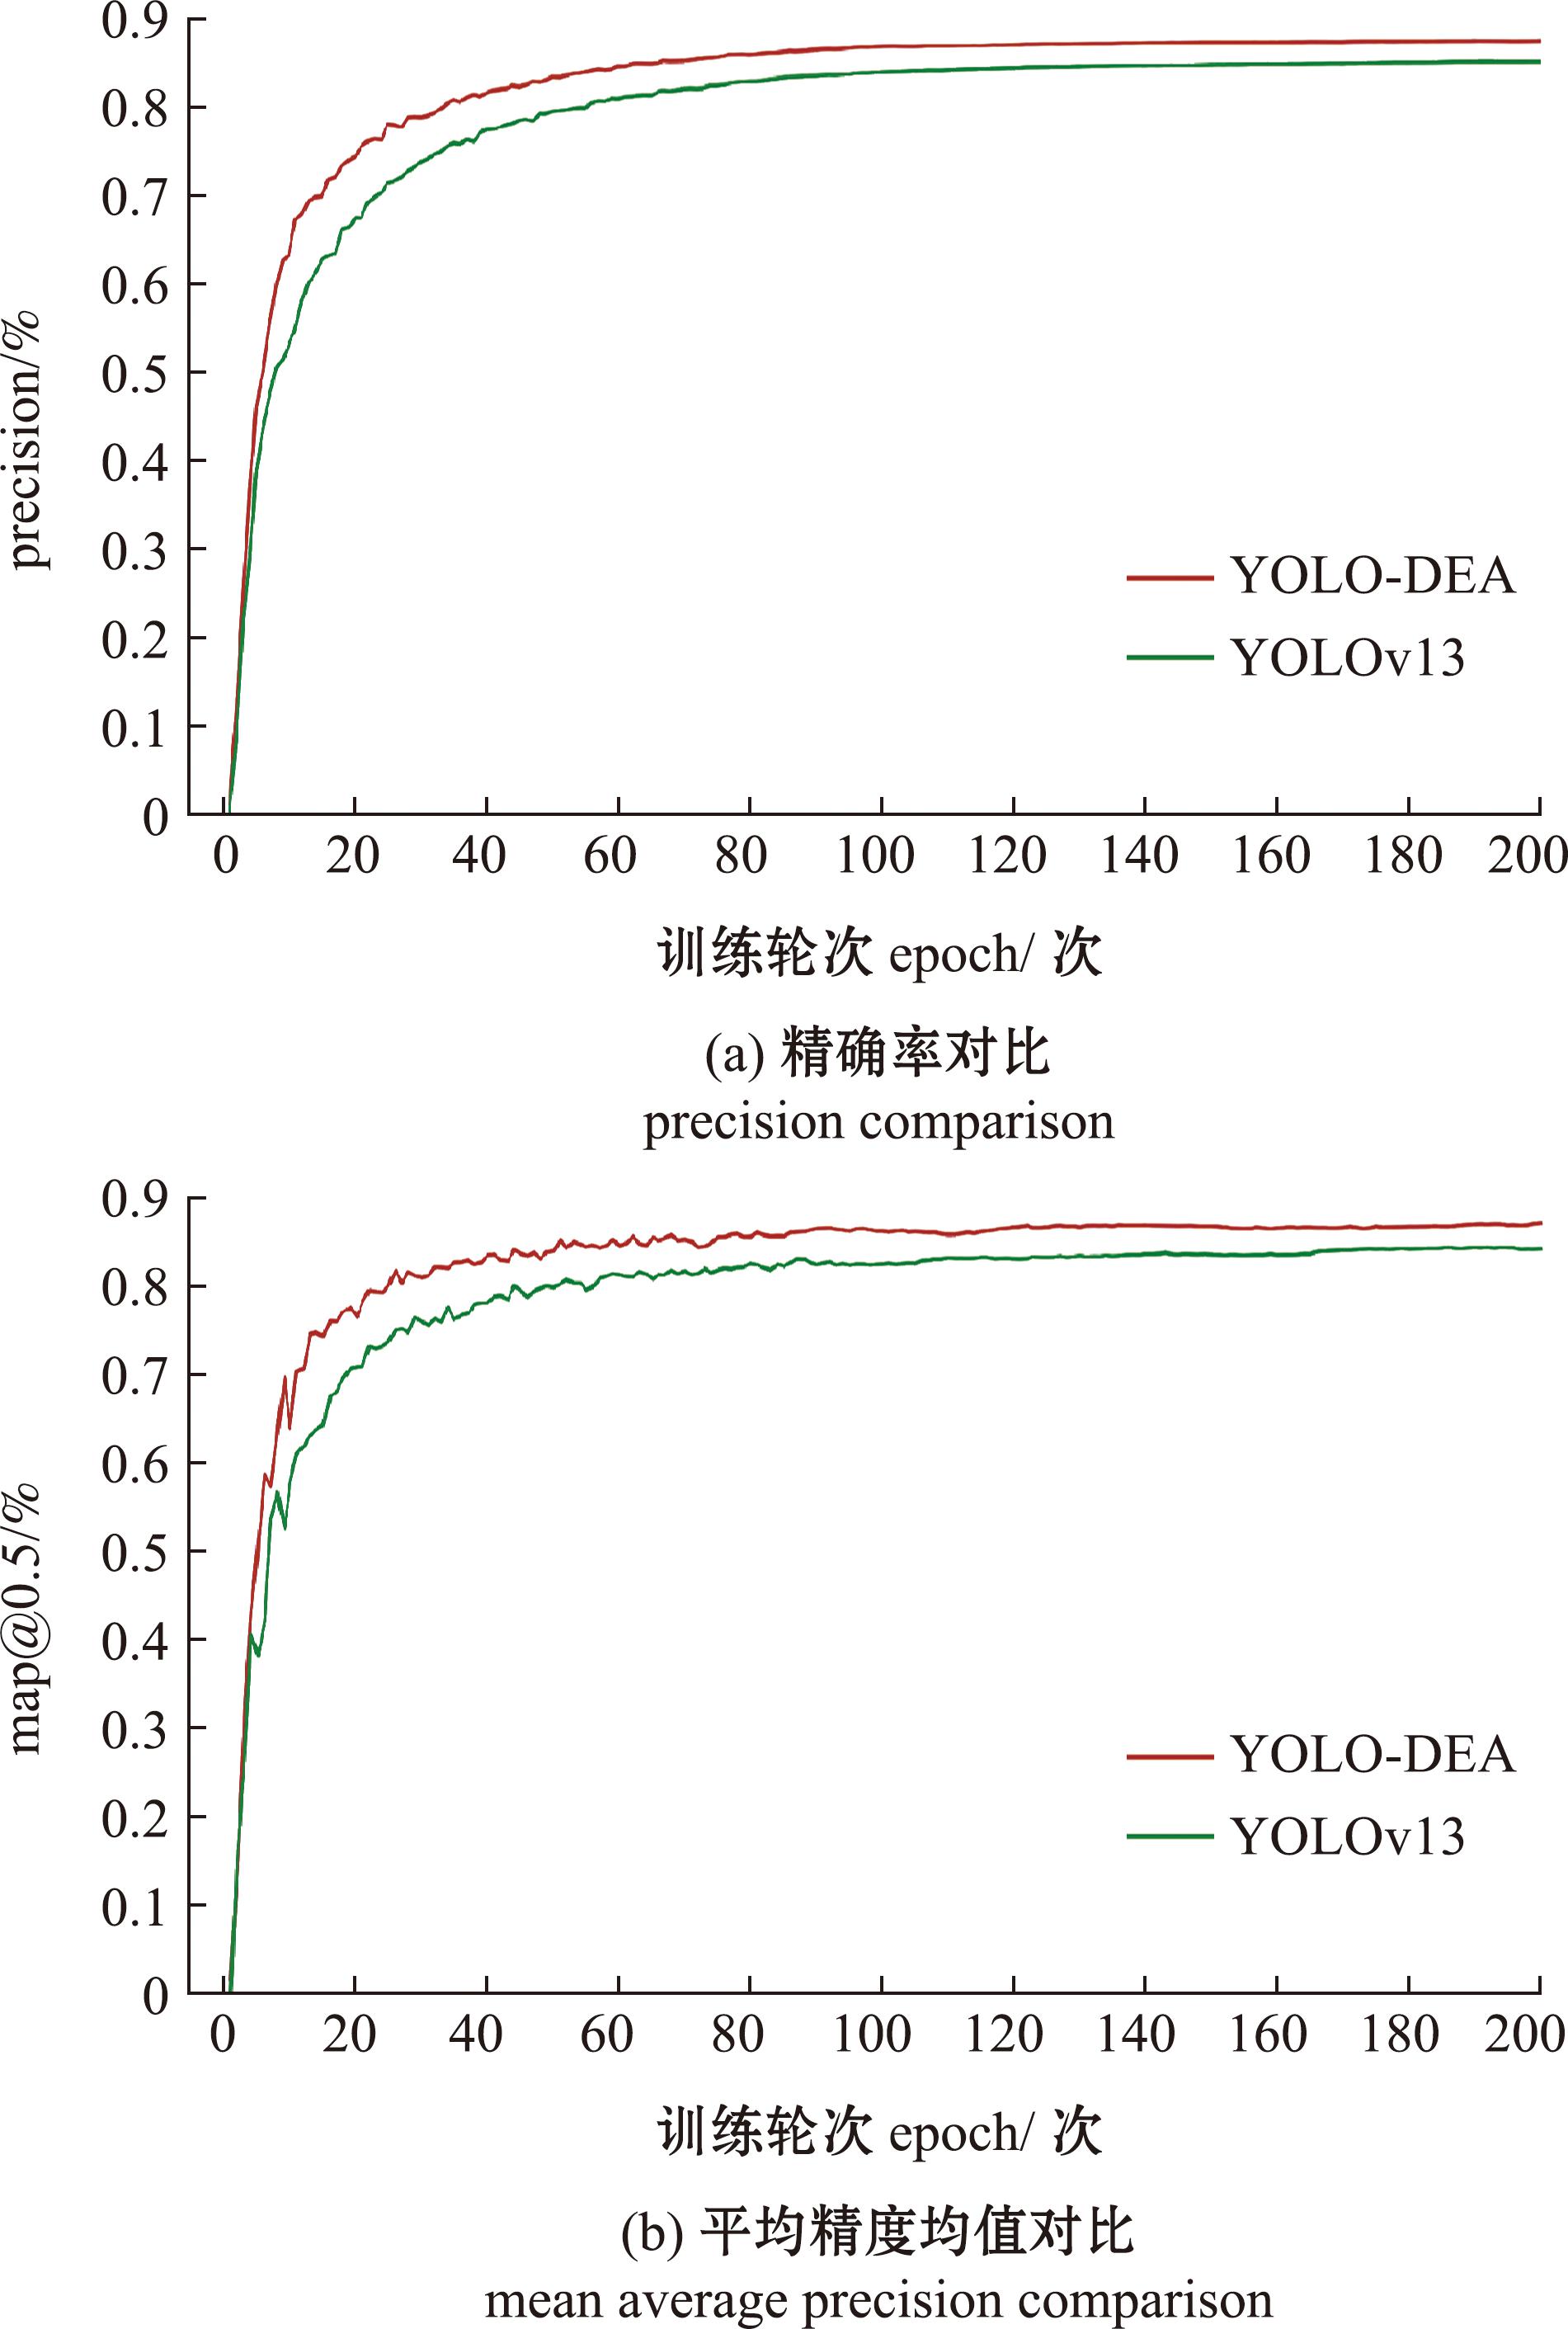
图6 YOLOv13n与YOLO-DEA模型训练过程指标变化曲线
Fig.6 Curves of precision and mAP during training for YOLOv13n and YOLO-DEA
3.5 消融试验设计与分析
为评估DynamicConv、EMCA和ATFL对YOLOv13n模型性能的不同影响,本试验以RUOD数据集为基准,在相同训练配置和硬件环境下进行消融试验,结果见表3。
表3 消融试验
Tab.3 Ablation study results
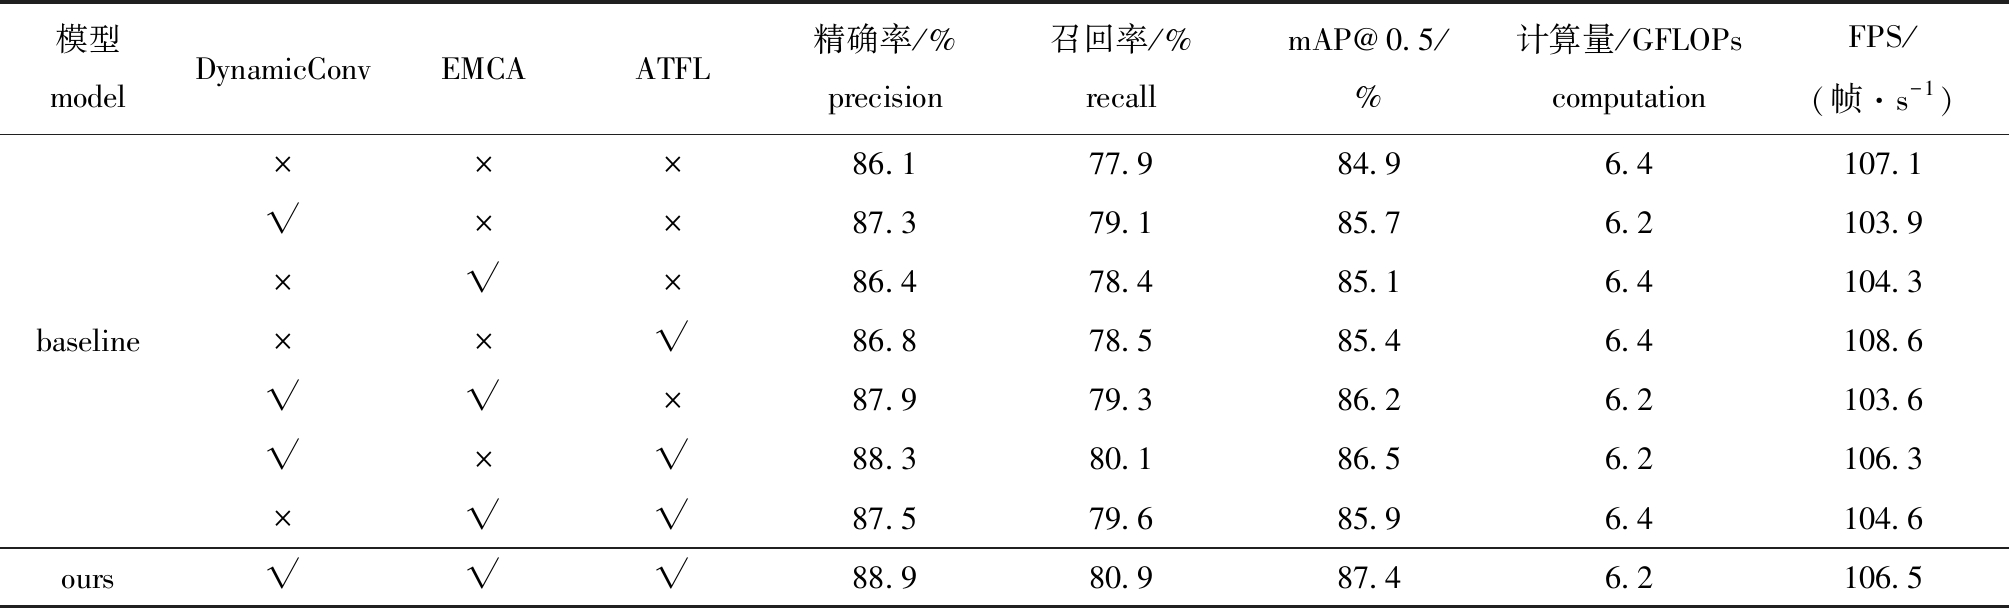
注:×表示不使用该改进策略,√表示使用该改进策略。
Note:× means that the improvement strategy is not adopted,and √ means that it is adopted.
模型modelDynamicConvEMCAATFL精确率/%precision召回率/%recallmAP@0.5/%计算量/GFLOPscomputationFPS/(帧·s-1)×××86.177.984.96.4107.1√××87.379.185.76.2103.9×√×86.478.485.16.4104.3baseline××√86.878.585.46.4108.6√√×87.979.386.26.2103.6√×√88.380.186.56.2106.3×√√87.579.685.96.4104.6ours√√√88.980.987.46.2106.5
从表3可见,仅将DS-Conv替换为DynamicConv后,精确率、召回率和mAP@0.5分别提升了1.2%、1.2%和0.8%,计算量减少了3.1%,FPS为103.9 帧/s;单独加入EMCA模块时,精确率、召回率和mAP@0.5分别提升了0.3%、0.5%和0.2%,FPS为104.3 帧/s;单独使用ATFL损失函数时,精确率、召回率和mAP@0.5分别提升了0.7%、0.6%和0.5%,FPS为108.6 帧/s。可见当DynamicConv、EMCA和ATFL 3个模块单独使用时均能提升模型检测性能。进一步分析不同模块的组合效果可发现,当任意两个模块组合使用时,模型性能均优于单模块方案。当将DynamicConv、EMCA和ATFL 3个方法集成到YOLOv13n模型时,精确率、召回率和mAP@0.5分别提升了2.8%、3.0%和2.5%,计算量减少了3.1%,FPS为106.5 帧/s,说明3个模块在特征建模、注意力分配与损失优化层面形成了有效协同,能在海洋牧场水下生物目标检测任务中在保证检测速度的同时,提升模型的检测精度。
3.6 改进模型与其他模型的性能对比试验
为验证改进模型YOLO-DEA在海洋牧场水下生物检测任务中的性能优势,在相同试验环境下,将其与Faster R-CNN、YOLOv8n、YOLOv10n、YOLO11n、YOLO12n、RT-DETRv2-R18和YOLOv13n主流检测模型在RUOD和URPC2020数据集上进行对比试验,见表4和表5。
表4 模型在RUOD数据集上的性能对比
Tab.4 Comparison of model performance on the RUOD dataset
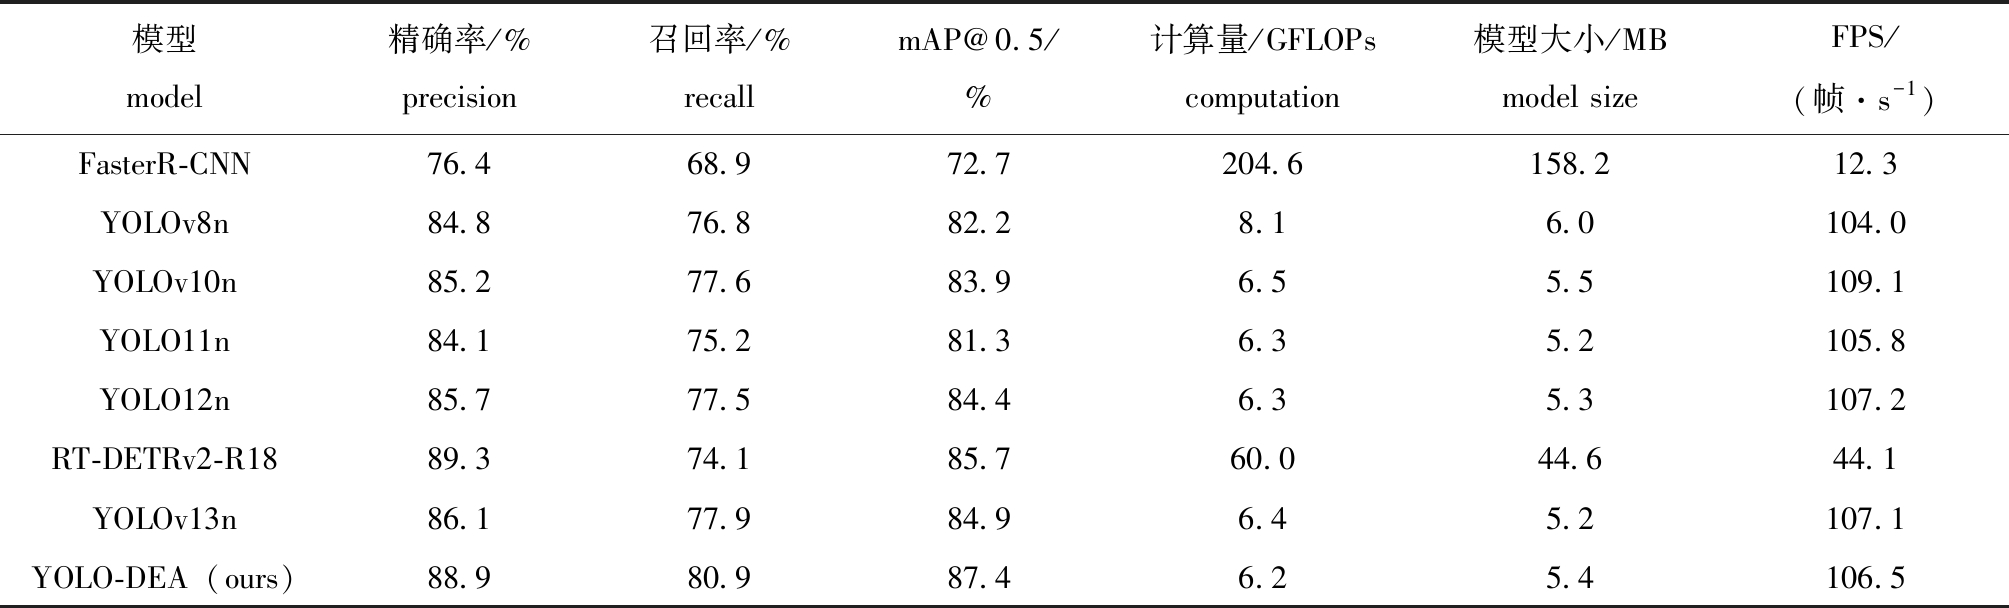
模型model精确率/%precision召回率/%recallmAP@0.5/%计算量/GFLOPscomputation模型大小/MBmodel sizeFPS/(帧·s-1)FasterR-CNN76.468.972.7204.6158.212.3YOLOv8n84.876.882.28.16.0104.0YOLOv10n85.277.683.96.55.5109.1YOLO11n84.175.281.36.35.2105.8YOLO12n85.777.584.46.35.3107.2RT-DETRv2-R1889.374.185.760.044.644.1YOLOv13n86.177.984.96.45.2107.1YOLO-DEA(ours)88.980.987.46.25.4106.5
表5 模型在URPC2020数据集上的性能对比
Tab.5 Comparison of model performance on the URPC2020 dataset
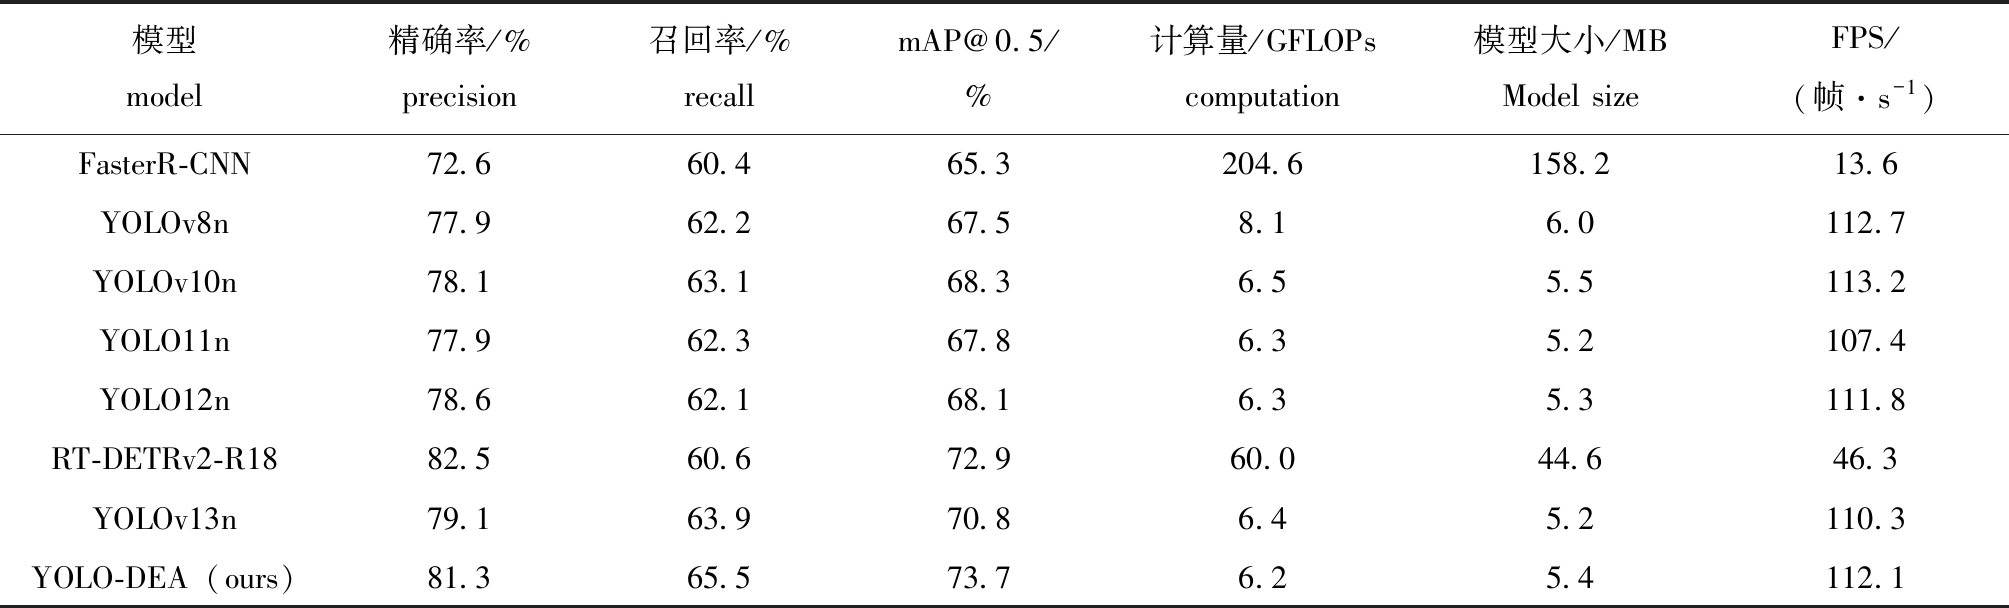
模型model精确率/%precision召回率/%recallmAP@0.5/%计算量/GFLOPscomputation模型大小/MBModel sizeFPS/(帧·s-1)FasterR-CNN72.660.465.3204.6158.213.6YOLOv8n77.962.267.58.16.0112.7YOLOv10n78.163.168.36.55.5113.2YOLO11n77.962.367.86.35.2107.4YOLO12n78.662.168.16.35.3111.8RT-DETRv2-R1882.560.672.960.044.646.3YOLOv13n79.163.970.86.45.2110.3YOLO-DEA(ours)81.365.573.76.25.4112.1
从表4和表5可见,YOLO-DEA模型的精确率、召回率和mAP@0.5在RUOD数据集上分别达到了88.9%、80.9%和87.4%,在URPC2020数据集上分别达到了81.3%、65.5%和73.7%,其中mAP@0.5和计算量均优于Faster R-CNN、YOLOv8n、YOLOv10n、YOLO11n、YOLO12n、RT-DETRv2-R18和YOLOv13n模型。虽然YOLO-DEA模型精确率略低于RT-DETRv2-R18模型,但其计算量仅为RT-DETRv2-R18模型的10.3%,同时在RUOD数据集上FPS高出62.4帧/s。通过对比试验结果分析可知,YOLO-DEA模型的检测性能显著优于Faster R-CNN、YOLOv8n、YOLOv10n、YOLO11n、YOLO12n、RT-DETRv2-R18和YOLOv13n主流检测模型,充分验证了改进模型在海洋牧场水下生物检测任务中优越的检测精度与泛化能力。
3.7 改进方法的跨模型通用性试验
为验证所提改进方法(DynamicConv、EMCA和ATFL)的通用性,本试验将其整体集成到YOLOv8n、YOLOv10n、YOLO11n和YOLO12n检测模型中,在RUOD数据集上进行试验,结果见表6。
表6 改进方法的跨模型验证
Tab.6 Cross-model validation of the proposed method
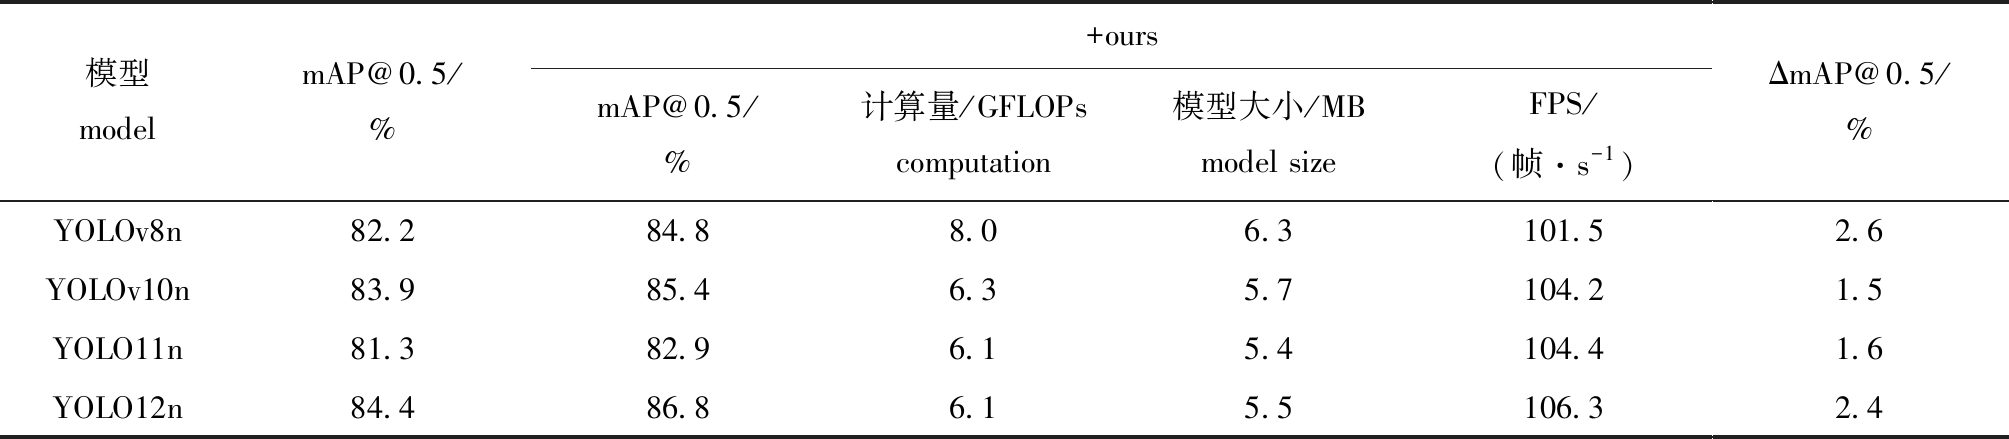
注:ΔmAP@0.5/%表示模型+ours相对于baseline模型的mAP@0.5提升幅度。
Note:ΔmAP@0.5/% denotes the mAP@0.5 improvement of the +ours model over the corresponding baseline model.
模型modelmAP@0.5/%+oursmAP@0.5/%计算量/GFLOPscomputation模型大小/MBmodel sizeFPS/(帧·s-1)ΔmAP@0.5/%YOLOv8n82.284.88.06.3101.52.6YOLOv10n83.985.46.35.7104.21.5YOLO11n81.382.96.15.4104.41.6YOLO12n84.486.86.15.5106.32.4
从表6可见,集成本文方法后,YOLOv8n、YOLOv10n、YOLO11n和YOLO12n的mAP@0.5分别提升了2.6%、1.5%、1.6%和2.4%。同时,各模型仍保持较低的计算量和模型大小,并具有较高的FPS,表明本方法具有良好的通用性,能够有效提升不同YOLO基础模型在海洋牧场水下目标检测任务中的性能。
3.8 改进模型与原模型的检测效果可视化分析
为更直观地比较YOLO-DEA和YOLOv13n模型的检测精度,本研究中选取部分典型测试图像进行对比分析,结果可视化如图7所示。从图7可见,YOLO-DEA有效缓解了错检、漏检问题,在复杂的水下环境中保持着更高的检测精度和鲁棒性。
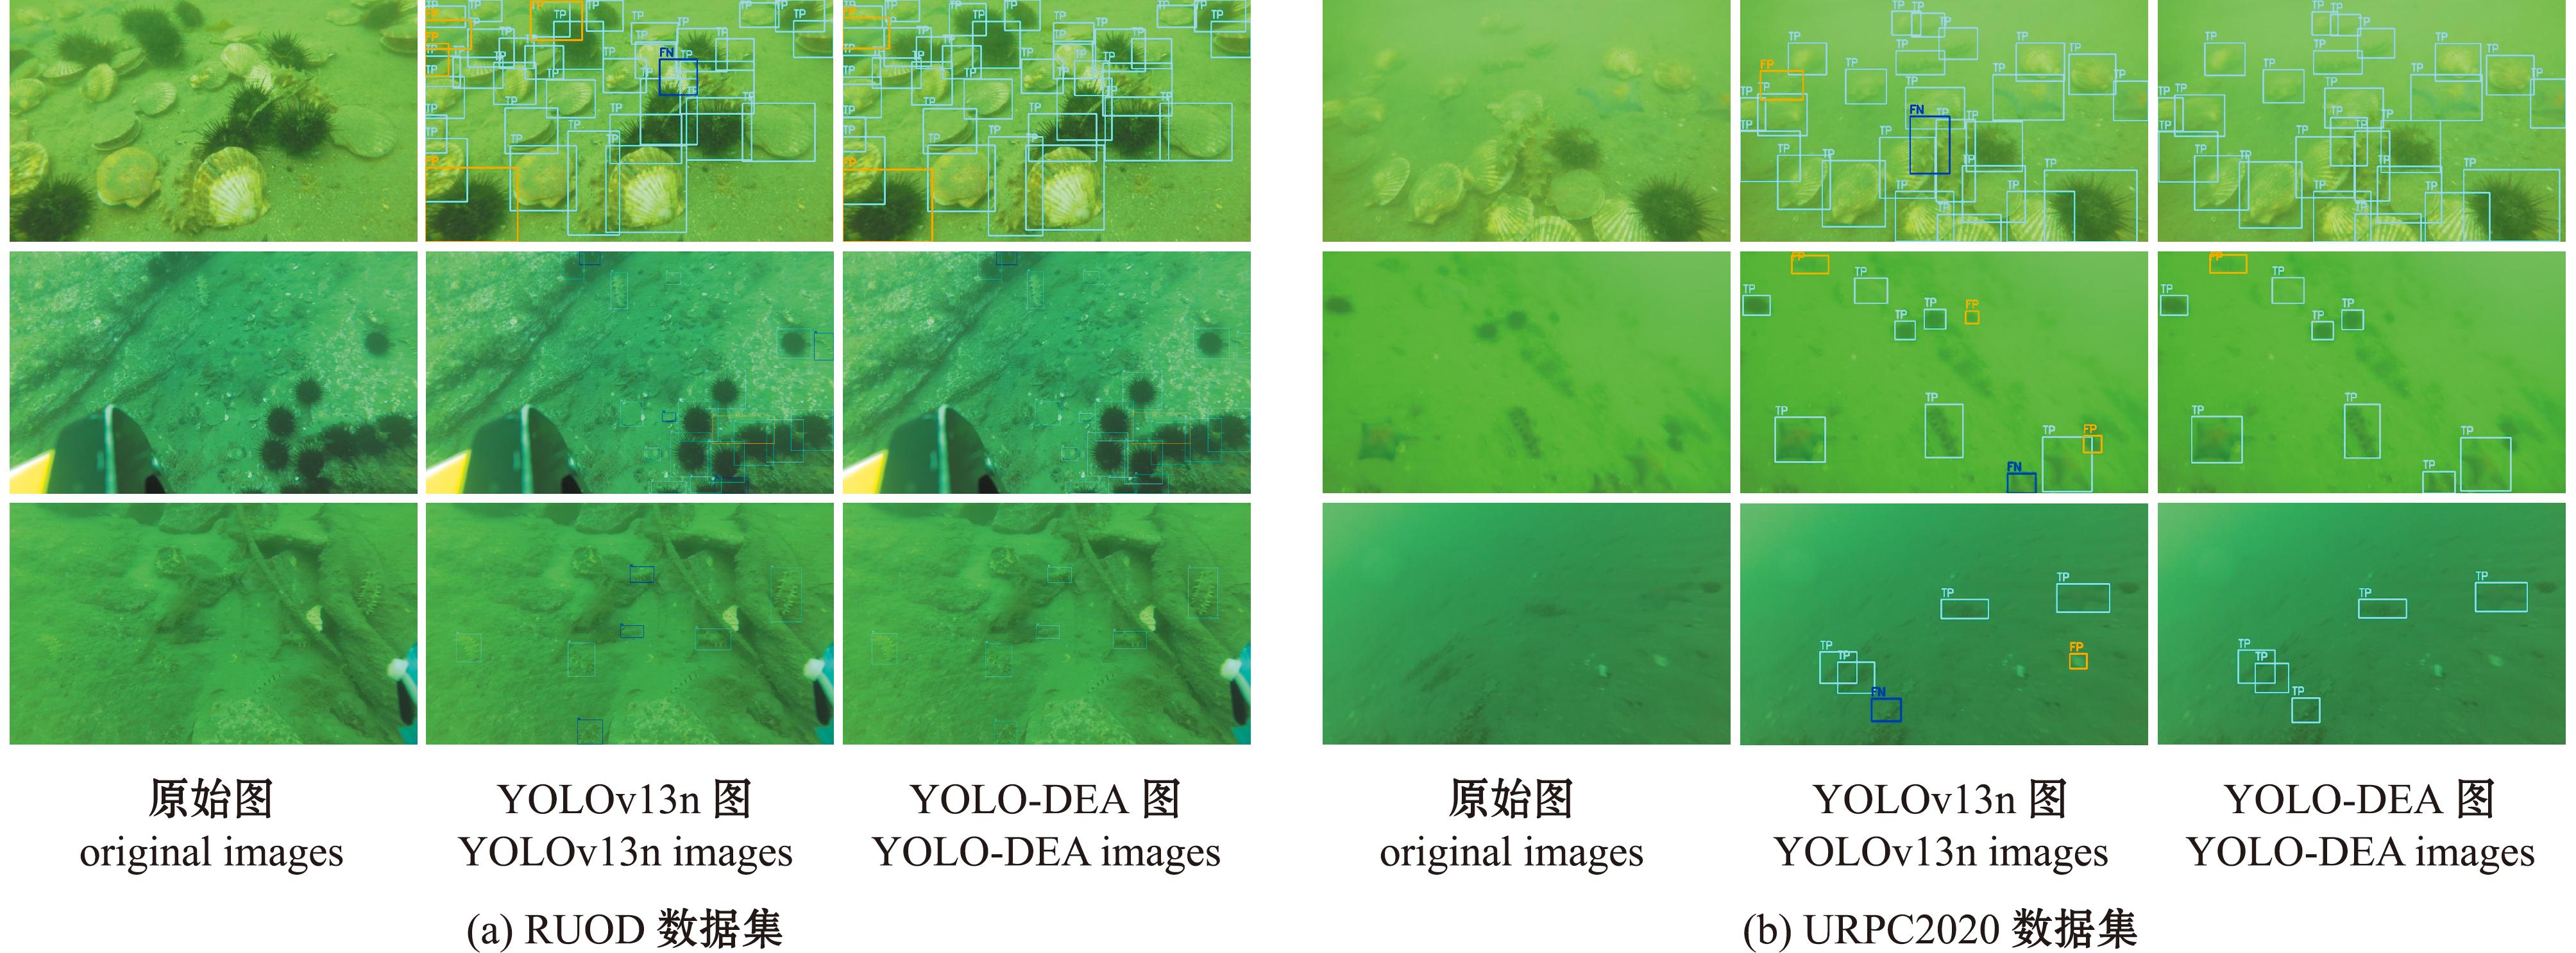
青色框表示正确检测的目标(TP);橙色框表示误检的目标(FP);蓝色框表示漏检的目标(FN)。
The cyan box represents the targets detected correctly(TP);the orange box represents the targets detected falsely (FP);the blue box represents the targets missed(FN).
图7 YOLOv13n与YOLO-DEA模型检测结果可视化对比
Fig.7 Visual comparison of detection results between YOLOv13n and YOLO-DEA models
4 讨论
4.1 引入动态卷积对模型检测性能的影响
动态卷积能够根据输入特征自适应生成卷积核权重,使卷积响应随样本特性动态调整,从而增强网络对水下生物因姿态、光照和背景变化产生特征差异的表达能力。与传统卷积相比,动态卷积具备更强的特征建模能力。Li等[31]提出一种改进YOLOv7的融合注意力与动态卷积的小目标检测算法,通过引入动态卷积显著增强了原始模型对不同规模目标的适应性,使模型的mAP@0.5提升了3.5%。谢国波等[32]提出改进YOLOv8n的轻量级水下目标检测算法,该算法通过引入融合动态卷积的PR-DyHead替换原有检测头,使模型的精确率、召回率和mAP@0.5分别提升了0.33%、0.84%和0.61%。许京新等[33]提出融合自适应卷积神经网络的SAR图像舰船目标检测方法,该方法在引入融合动态卷积的OD-ELAN模块后,模型的精确率、召回率和mAP@0.5分别提升了3.86%、3.39%和4.28%。结合上述研究及本文研究结果,引入动态卷积能够有效提升目标检测模型的精度。在海洋牧场实际检测场景中,动态卷积还可与轻量化主干网络、高效注意力机制或硬件加速策略相结合,进一步优化模型的综合性能。
4.2 引入注意力机制对模型检测性能的影响
注意力机制通过对特征进行自适应加权,引导模型在特征提取与融合过程中重点关注与目标检测任务高度相关的信息,从而有效抑制冗余特征和复杂背景干扰。李江川等[34]提出一种基于结构重参数化和双重注意力机制的水下目标检测算法,通过引入融合ESE注意力机制的RepViT-M2,使模型的mAP@0.5提升了1.2%,但FPS下降10帧/s。梁秀满等[35]提出基于YOLOv8的轻量化水下目标检测算法,通过在YOLOv8n网络中加入LSKA可分离核注意力机制,使模型的mAP@0.5提升了1.6%,但FPS下降14帧/s。谢国波等[32]提出改进YOLOv8n的轻量级水下目标检测算法,通过引入改进CBAM的GAM注意力机制,使模型精确率、召回率和mAP@0.5分别提升了0.54%、1.31%和1.33%,但模型的计算量增加32.1%。结合上述研究可见,在目标检测模型中引入注意力机制有助于提升模型的检测精度,但通常伴随着一定程度的检测速度下降,本文构建的EMCA注意力机制在结构设计上更加注重轻量化与特征选择的平衡,在几乎不增加计算量的同时提升模型在海洋牧场水下生物目标检测任务中的性能。
4.3 ATFL对模型检测性能的影响
自适应阈值焦点损失函数(ATFL)通过引入基于预测置信度的动态调制因子,对样本损失进行自适应加权,在保证高置信度样本稳定训练的同时,增强模型对低置信度样本的学习能力,从而提升模型整体检测精度。与传统损失函数Focal Loss相比,ATFL使模型在海洋牧场复杂水下环境下能更准确、高效地学习目标特征。消融试验结果显示,在基础模型中引入ATFL后,精确率、召回率和mAP@0.5分别提升了0.7%、0.6%和0.6%,模型的计算量为6.4GFLOPs,FPS为108.6帧/s,ATFL在不影响检测模型实时性的同时能够有效提升模型的检测精度。
4.4 复杂水下环境中的适应性分析与改进方向
尽管本文提出的YOLO-DEA模型在RUOD与URPC2020数据集上取得了较优的检测精度与实时性能,但在远距离小目标、低能见度、强遮挡或密集分布场景中(图7)仍存在漏检和误检。分析后得知,DynamicConv的空间依赖建模仍主要基于局部感受野,导致极低对比度目标的高层语义表征仍然不足;EMCA主要侧重于通道维度的信息重标定,其对长距离空间依赖关系的显式建模能力相对有限,当海藻、珊瑚等背景结构与目标在纹理和颜色分布上高度相似时,模型仍可能产生误检;在强遮挡及高度密集分布场景中,虽然ATFL在一定程度上增强了困难样本的梯度贡献,但在目标严重重叠的情况下,预测框回归误差与非极大值抑制的阈值敏感性仍可能影响最终检测结果。未来可进一步引入轻量化全局空间建模机制或结合可变形注意力结构,以弥补卷积局部建模的不足,同时构建海洋牧场水下场景更具代表性的低能见度与密集遮挡子场景数据,以进一步提升模型在实际海洋牧场中的稳定性与泛化能力。
5 结论
1)本研究中提出了一种基于改进YOLOv13的海洋牧场水下生物目标检测模型YOLO-DEA。该模型在RUOD和URPC2020数据集上的mAP@0.5分别为87.4%和73.7%,较YOLOv13n模型分别提升了2.5%和2.9%;同时,其模型计算量为6.2 GFLOPs,相较原模型降低了0.2 GFLOPs。YOLO-DEA模型能够满足对海洋牧场水下生物的准确、快速检测,可大幅提高海洋牧场水下生物的管理效率。
2)本研究中通过引入DynamicConv动态卷积,构建EMCA注意力机制,设计ATFL损失函数,显著提升了模型的检测精度,实现了检测效果和检测速度兼顾。改进后的模型可为海洋牧场的智能化和自动化发展提供有益参考。
3)本研究中提出的YOLO-DEA模型相较于其他主流模型如Faster R-CNN、YOLOv8n、YOLOv10n、YOLO11n、YOLO12n、RT-DETRv2-R18和YOLOv13n模型,具有更好的检测效果,其计算量为6.2 GFLOPs,模型大小为5.4 MB,FPS为106.5帧/s,适宜部署在算力资源不足的设备上。
[1] 杨红生.我国海洋牧场建设回顾与展望[J].水产学报,2016,40(7):1133-1140.YANG H S.Construction of marine ranching in China:reviews and prospects[J].Journal of Fisheries of China,2016,40(7):1133-1140.(in Chinese)
[2] WU Z J,MA J T,ZHOU Y F,et al.How does ocean farming empower the fishery economy A policy impact evaluation of marine ranch demonstration zones[J].Frontiers in Marine Science,2025,12:1683414.
[3] 李俞锋,杨仁友.光学技术在海洋养殖中的应用与展望[J].农业工程学报,2025,41(6):9-19.LI Y F,YANG R Y.Applications and prospects of optical technology in marine culture[J].Transactions of the Chinese Society of Agricultural Engineering,2025,41(6):9-19.(in Chinese)
[4] ULUTAS G,USTUBIOGLU B.Underwater image enhancement using contrast limited adaptive histogram equalization and layered difference representation[J].Multimedia Tools and Applications,2021,80(10):15067-15091.
[5] BADAWI U A.Fish classification using extraction of appropriate feature set[J].International Journal of Electrical and Computer Engineering (IJECE),2022,12(3):2488.
[6] THARWAT A,HEMEDAN A A,HASSANIEN A E,et al.A biometric-based model for fish species classification[J].Fisheries Research,2018,204:324-336.
[7] 李静,徐路路.基于机器学习算法的研究热点趋势预测模型对比与分析:BP神经网络、支持向量机与LSTM模型[J].现代情报,2019,39(4):23-33.LI J,XU L L.Comparison and analysis of research trend prediction models based on machine learning algorithm:BP neural network,support vector machine and LSTM model[J].Modern Information,2019,39(4):23-33.(in Chinese)
[8] AMANULLAH M,SELVAKUMAR V,JYOT A,et al.CNN based prediction analysis for web phishing prevention[C]//2022 International Conference on Edge Computing and Applications (ICECAA).October 13-15,2022,Tamilnadu,India.IEEE,2022:1-7.
[9] GIRSHICK R,DONAHUE J,DARRELL T,et al.Rich feature hierarchies for accurate object detection and semantic segmentation[C]//2014 IEEE Conference on Computer Vision and Pattern Recognition.June 23-28,2014,Columbus,OH,USA.IEEE,2014:580-587.
[10] REN S Q,HE K M,GIRSHICK R,et al.Faster R-CNN:towards real-time object detection with region proposal networks[J].IEEE Transactions on Pattern Analysis and Machine Intelligence,2017,39(6):1137-1149.
[11] LIU Z G,DU J,TIAN F,et al.MR-CNN:a multi-scale region-based convolutional neural network for small traffic sign recognition[J].IEEE Access,2019,7:57120-57128.
[12] LIN T Y,DOLL R P,GIRSHICK R,et al.Feature pyramid networks for object detection[C]//2017 IEEE Conference on Computer Vision and Pattern Recognition (CVPR).July 21-26,2017,Honolulu,HI,USA.IEEE,2017:936-944.
[13] REDMONJ,DIVVALA S,GIRSHICK R,et al.You only look once:unified,real-time object detection[C]//2016 IEEE Conference on Computer Vision and Pattern Recognition (CVPR).June 27-30,2016,Las Vegas,NV,USA.IEEE,2016:779-788.
[14] AL MUKSIT A,HASAN F,HASAN BHUIYAN EMON M F,et al.YOLO-Fish:a robust fish detection model to detect fish in realistic underwater environment[J].Ecological Informatics,2022,72:101847.
[15] 刘萍,杨鸿波,宋阳.改进YOLOv3网络的海洋生物识别算法[J].计算机应用研究,2020,37(sup1):394-397.LIU P,YANG H B,SONG Y.Marine biometric recognition algorithm based on improved YOLOv3 network[J].Application Research of Computers,2020,37(sup1):394-397.(in Chinese)
[16] LIU P Z,QIAN W B,WANG Y L.YWnet:a convolutional block attention-based fusion deep learning method for complex underwater small target detection[J].Ecological Informatics,2024,79:102401.
[17] 陈郁隈,朱晓龙,李超凡,等.基于深度细微特征提取的水下鱼类识别方法研究[J].大连海洋大学学报,2025,40(3):489-498.CHEN Y W,ZHU X L,LI C F,et al.A study on the underwater fish recognition method based on deep subtle features capture[J].Journal of Dalian Ocean University,2025,40(3):489-498.(in Chinese)
[18] 赵晨,陈明.水下底栖生物轻量化目标检测算法YOLOv7-RFPCW[J].农业工程学报,2024,40(11):168-177.ZHAO C,CHEN M.YOLOv7-RFPCW of a lightweight target detection algorithm for benthic organisms underwater[J].Transactions of the Chinese Society of Agricultural Engineering,2024,40(11):168-177.(in Chinese)
[19] 赵煜,方国艾,华顿.基于改进YOLOv5s-Seg的中华绒螯蟹不同部位检测分割方法[J].大连海洋大学学报,2025,40(2):338-350ZHAO Y,FANG G A,HUA D.Segmentation method for detecting different parts of Eriocheir sinensis based on improved YOLOv5-Seg[J].Journal of Dalian Fisheries University,2025,40(2):338-350.(in Chinese)
[20] 王芳,洪胜呈,刘可心,等.基于改进YOLOv8s与ByteTrack的养殖海参计数方法[J].农业工程学报,2025,41(13):234-242.WANG F,HONG S C,LIU K X,et al.Counting method for farmed sea cucumbers based on improved YOLOv8s and ByteTrack[J].Transactions of the Chinese Society of Agricultural Engineering,2025,41(13):234-242.(in Chinese)
[21] QU S M,CUI C,DUAN J L,et al.Underwater small target detection under YOLOv8-LA model[J].Scientific Reports,2024,14:16108.
[22] 李响,高国栋,张为,等.基于改进YOLOv8的扇贝破损检测模型[J].大连海洋大学学报,2025,40(4):695-704.LI X,GAO G D,ZHANG W,et al.Scallop damage detection model based on an improved YOLOv8 method[J].Journal of Dalian Ocean University,2025,40(4):695-704.(in Chinese)
[23] 刘侦龙,王骥,麦仁贵.基于改进YOLOv10s的海洋牧场水下海参检测方法[J].农业工程学报,2025,41(10):186-194.LIU Z L,WANG J,MAI R G.Detecting underwater sea cucumber in marine ranching using improved YOLOv10s[J].Transactions of the Chinese Society of Agricultural Engineering,2025,41(10):186-194.(in Chinese)
[24] FU C P,LIU R S,FAN X,et al.Rethinking general underwater object detection:Datasets,challenges,and solutions[J].Neurocomputing,2023,517:243-256.
[25] LEI M Q,LI S Q,WU Y H,et al.YOLOv13:real-time object detection with hypergraph-enhanced adaptive visual perception[EB/OL].2025:arXiv:2506.17733.https://arxiv.org/abs/2506.17733.
[26] WANG Q L,WU B G,ZHU P F,et al.ECA-net:efficient channel attention for deep convolutional neural networks[C]//2020 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR).June 13-19,2020,Seattle,WA,USA.IEEE,2020:11531-11539.
[27] OUYANG D L,HE S,ZHANG G Z,et al.Efficient multi-scale attention module with cross-spatial learning[C]//ICASSP 2023 - 2023 IEEE International Conference on Acoustics,Speech and Signal Processing (ICASSP).June 4-10,2023,Rhodes Island,Greece.IEEE,2023:1-5.
[28] WOO S,PARK J,LEE J Y,et al.CBAM:convolutional block attention module[M]//Computer Vision-ECCV 2018.Cham:Springer International Publishing,2018:3-19.
[29] HOU Q B,ZHOU D Q,FENG J S.Coordinate attention for efficient mobile network design[C]//2021 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR).June 20-25,2021,Nashville,TN,USA.IEEE,2021:13708-13717.
[30] LIU Y C,SHAO Z R,HOFFMANN N.Global attention mechanism:retain information to enhance channel-spatial interactions[EB/OL].2021:arXiv:2112.05561.https://arxiv.org/abs/2112.05561
[31] LI K,WANG Y N,HU Z M.Improved YOLOv7 for small object detection algorithm based on attention and dynamic convolution[J].Applied Sciences,2023,13(16):9316.
[32] 谢国波,梁立辉,林志毅,等.改进YOLOv8n的轻量级水下目标检测算法[J].激光与光电子学进展,2024,61(24):2437006.XIE G B,LIANG L H,LIN Z Y,et al.Lightweight underwater target detection algorithm based on improved YOLOv8n[J].Laser &Optoelectronics Progress,2024,61(24):2437006.(in Chinese)
[33] 许京新,王金伟,宋富骏,等.融合自适应卷积神经网络的SAR图像舰船目标检测方法[J].信号处理,2024,40(9):1696-1708.XU J X,WANG J W,SONG F J,et al.Fusion of adaptive convolutional neural networks for SAR images in ship target detection methods[J].Journal of Signal Processing,2024,40(9):1696-1708.(in Chinese)
[34] 李江川,韩彦岭,董传胜,等.YOLO-U:基于结构重参数化和双重注意力机制的水下目标检测算法[J].上海海洋大学学报,2025,34(3):696-706.LI J C,HAN Y L,DONG C S,et al.YOLO-U:an underwater object detection algorithm based on structural reparameterization and dual attention mechanism[J].Journal of Shanghai Ocean University,2025,34(3):696-706.(in Chinese)
[35] 梁秀满,赵佳阳,于海峰.基于YOLOv8的轻量化水下目标检测算法[J].红外技术,2024,46(9):1015-1024.LIANG X M,ZHAO J Y,YU H F.Lightweight underwater target detection algorithm based on YOLOv8[J].Infrared Technology,2024,46(9):1015-1024.(in Chinese)