魁蚶(Scapharca broughtonii)是一种大型海洋底栖双壳贝类,具有重要的经济价值[1],主要分布于中国、朝鲜、韩国、日本和俄罗斯沿海,其在中国以山东与辽宁的资源量最为丰富[2-3]。魁蚶具有高蛋白、低脂肪、氨基酸含量均衡丰富等优势。魁蚶养殖主要有两种方式:一是筏式养殖,即将魁蚶放入网笼悬挂于海面绳缆上养殖;二是底播增殖,即将魁蚶贝苗投放到海底自然生长,待长成后捕捞[4]。其中,捕捞后的魁蚶与生长碎片、其他海产品或杂物混杂在一起,为后续的智能化分拣带来了极大的困难,而利用深度学习模型对魁蚶进行检测识别可为魁蚶的智能分拣提供技术支持。
近年来,卷积神经网络被越来越多的学者应用于渔业与种植业目标检测领域,并产生了积极影响[5-6]。Li等[7]基于YOLOv5通过融合自适应的暗通道算法、分组卷积、逆残差块技术与减少颈部网络层数等方法,提出了一种轻量化的水下扇贝识别模型。张铮等[8]为解决模型参数量大的问题,提出了一种适用于水下环境的轻量级河蟹识别模型GCYOLOv5s,通过融合GhostNetV2的G3模块与幻影卷积可达到模型轻量化的目的。Liu等[9]基于YOLOv8n,通过引入多种减少非必要计算消耗的模块与MPDIoU损失函数,构建了轻量高效的Grain-YOLO模型,显著提升了水稻籽粒的检测精度与速度并部署在移动终端。Deng等[10]提出边缘感知的轻量级番茄检测框架SE-YOLO,该方法集成Sobel算子、增强边缘特征SEDFF模块与WFPIoU损失函数,模型在保持低计算成本的同时,显著提升了遮挡及其他复杂环境下番茄的检测精度,并成功部署于边缘设备。因此,轻量化的目标识别模型在促进渔业与种植业发展中起到了重要作用。
针对当前魁蚶筛选过程中存在的问题,本研究基于魁蚶在不同背景环境构建魁蚶图像数据集,并提出一种DSDC-YOLOv11n目标检测模型,以YOLOv11n为基础模型,通过在主干网络和颈部网络中引入深度可分离卷积(depthwise separable convolution,DSConv)、在主干网络采用空间与通道重建卷积(spatial and channel reconstruction convolution,SCConv)优化C3k2模块的瓶颈结构组成特征提取模块SCC3k2(spatial and channel reconstruction convolution cross stage partial with kernel size 2)、在头部网络中引入动态卷积,提出新的检测头——动态卷积检测头(dynamic convolution head,DCHead),采用损失函数(wise-intersection over union,Wise-IoU)替换原有的损失函数的方法进行优化,在确保检测精度的同时兼顾轻量化与检测速度,从而实现魁蚶高效率且低误差识别。
1 数据集构建
1.1 数据获取
本研究基于网络爬虫法与实地采集法构建魁蚶图像数据集。网络爬虫法通过编写Python脚本,调用百度图片搜索接口,以“魁蚶”和“赤贝”为关键词进行定向图像检索。经人工筛选,剔除重复、破损及加工后的样本,最终保留300张符合要求的魁蚶图像。实地采集样本源自大连本地市场,采用Intel RealSense D435i相机进行拍摄,剔除重复及模糊样本后,共获得1 158张有效图像。本研究建立的魁蚶数据集共1 458张原始图像,涵盖单个魁蚶、多个魁蚶、贝类遮挡与魁蚶重叠等多种实际工况,兼顾背景多样性与拍摄条件异质性,以增强模型泛化能力,典型样本如图1所示。
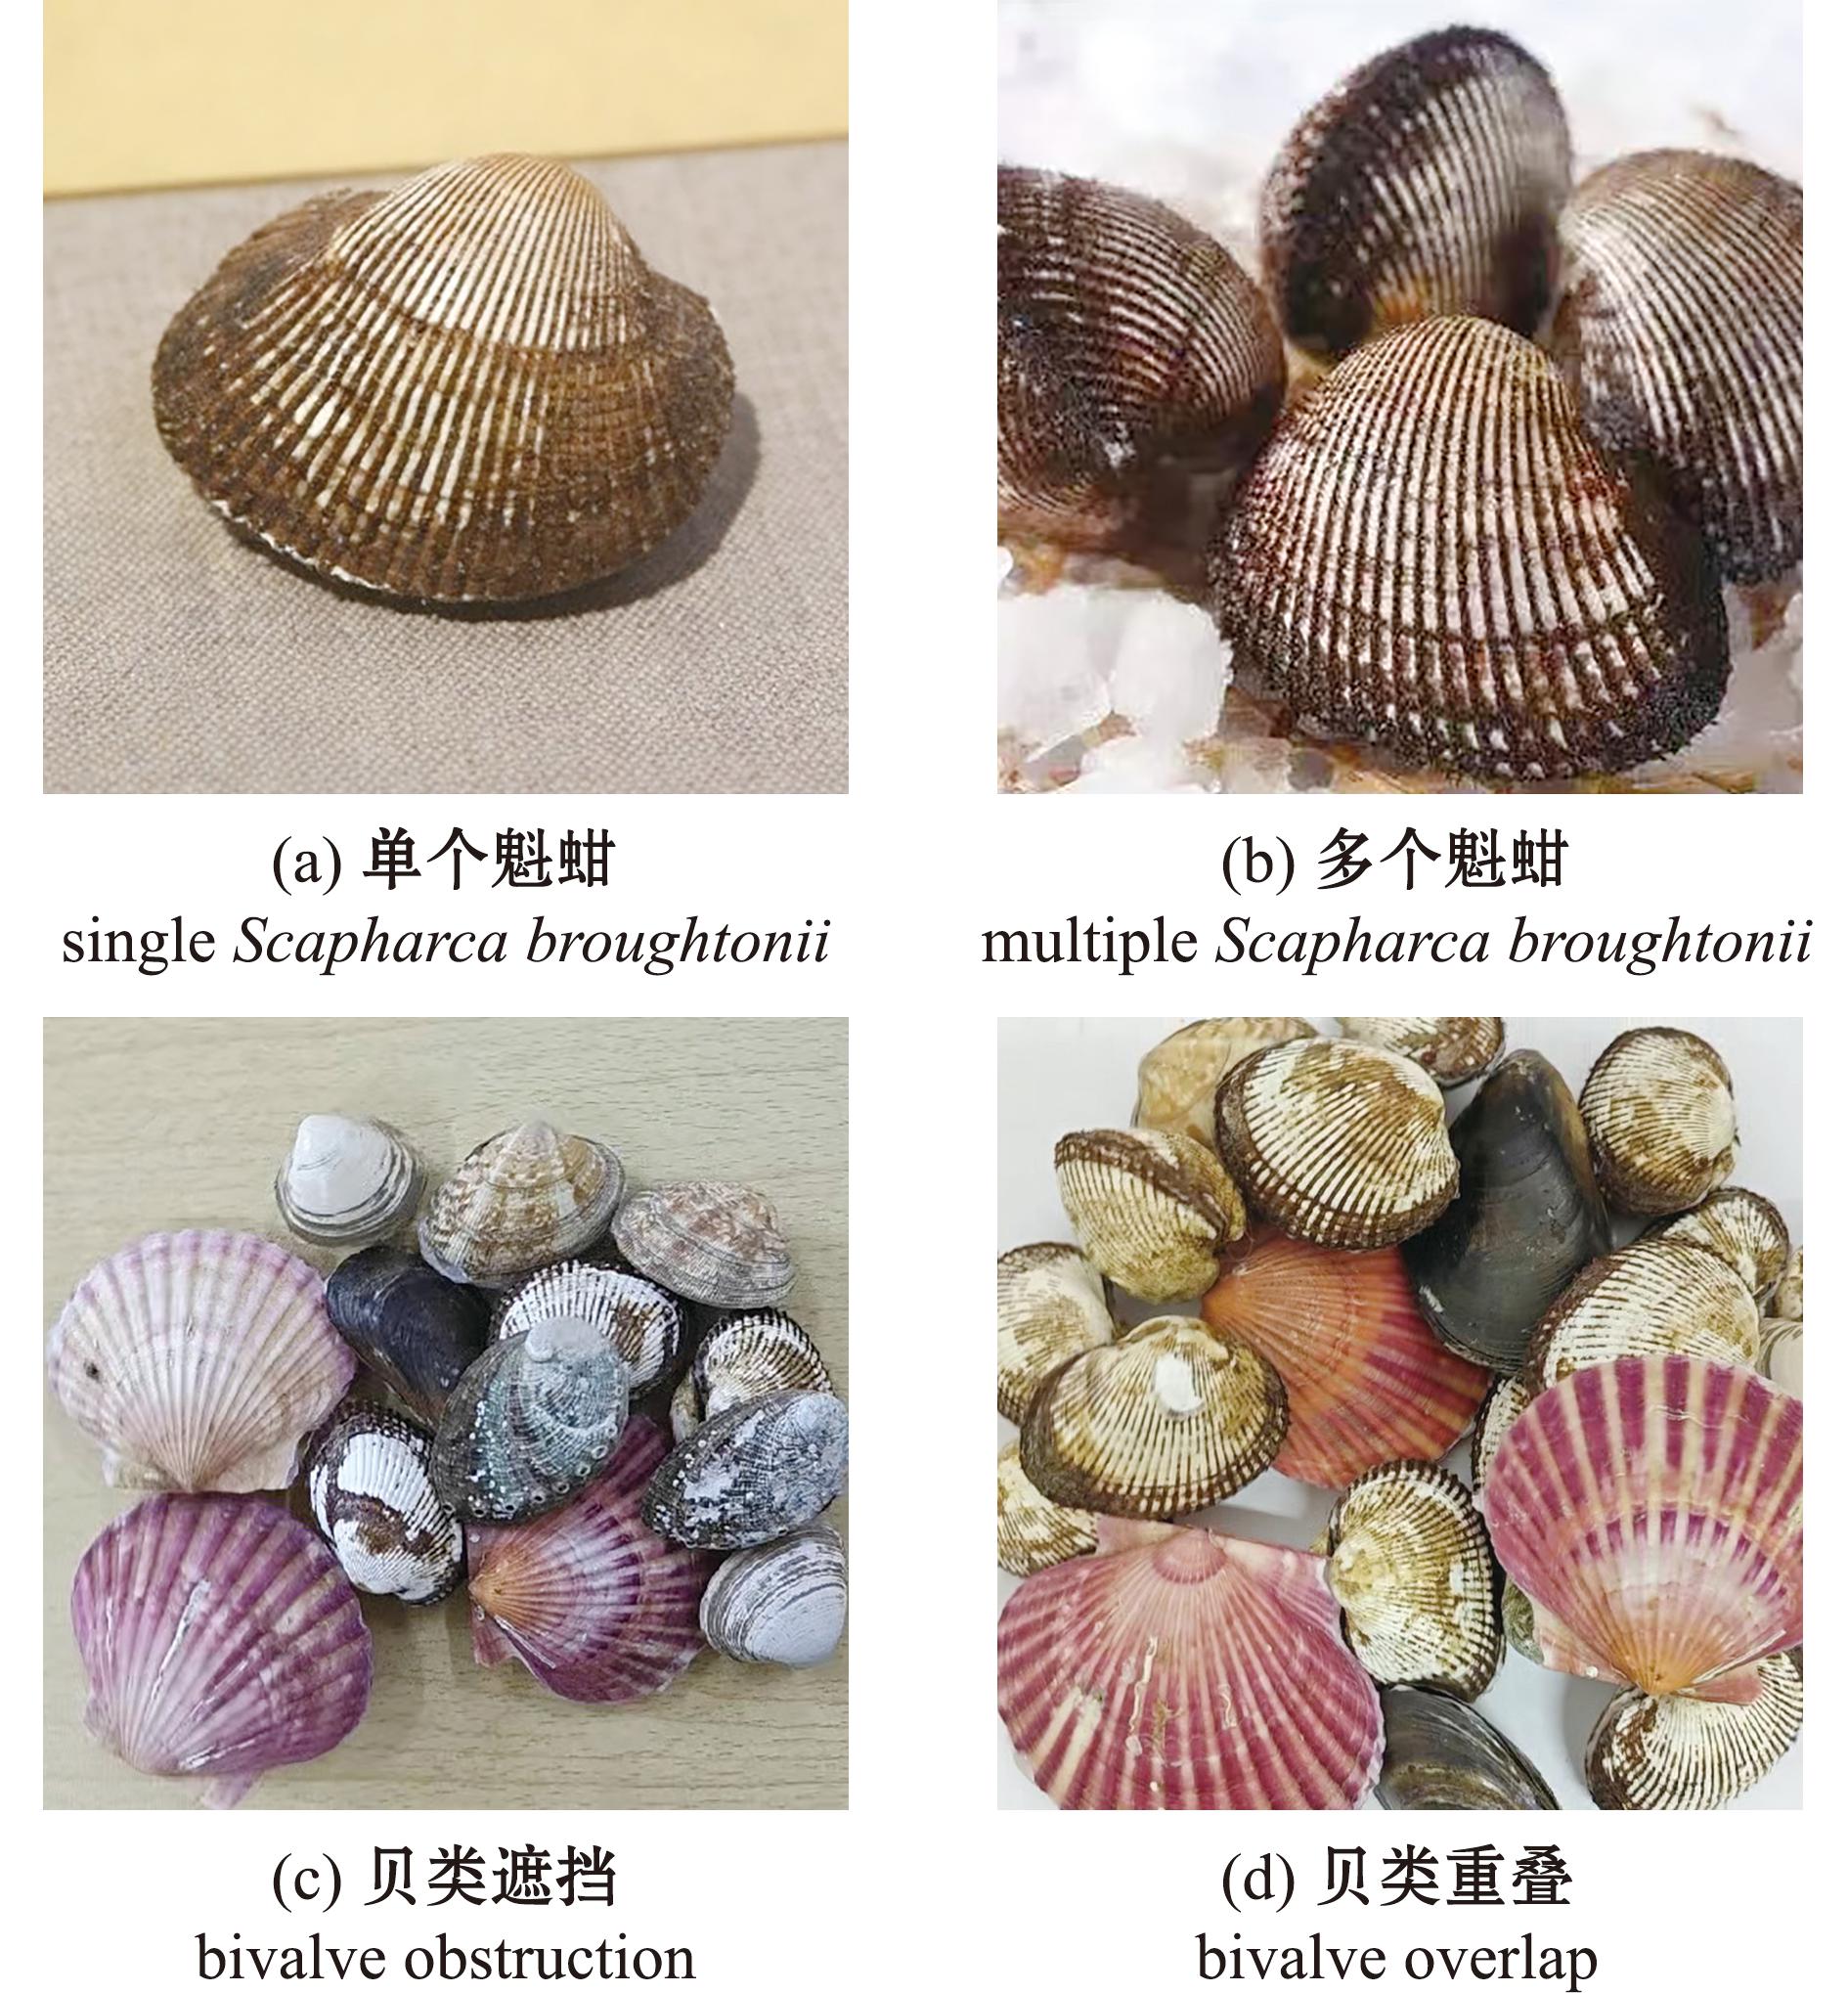
图1 魁蚶数据集示例
Fig.1 Examples of Scapharca broughtonii dataset
1.2 数据预处理
针对实际筛选场景中低光照、雨雾天气及表面泥污等干扰因素对图像质量的影响,本研究在数据预处理阶段引入多种数据增强策略,包括随机旋转、高斯噪声注入、随机亮度与对比度调整,以模拟复杂环境条件,提升模型在干扰下的鲁棒性与泛化性能。为避免模型对增强特征的过度依赖,每个样本仅施加单一增强操作,最终构建含2 916张图像的增强数据集。数据集经过LabelImg工具进行标注,生成包含类别标签与边界框坐标的txt文件。数据集按8∶1∶1比例划分为训练集、验证集与测试集,其中训练集2 334张图像,验证集291张图像,测试集291张图像。
2 魁蚶识别方法
2.1 YOLOv11n基础模型
YOLOv11[11]是由Ultralytics公司于2024年推出的YOLO系列架构,作为当前目标检测领域的前沿模型,其在YOLOv8的基础上进行了系统性优化与结构创新,在准确率和检测速度上均取得了显著提升,具备支持目标检测、实例分割及姿态估计等多任务处理的能力。该系列包含n、s、m、l、x 5种不同规模的变体,其中,YOLOv11n作为参数最少、计算开销最低的轻量化版本,在显著降低模型复杂度与推理延迟的同时,仍保持了较高的检测精度,实现了效率与性能的优异平衡,因此本研究选择YOLOv11n为识别任务的基础网络架构,其网络结构如图2所示。
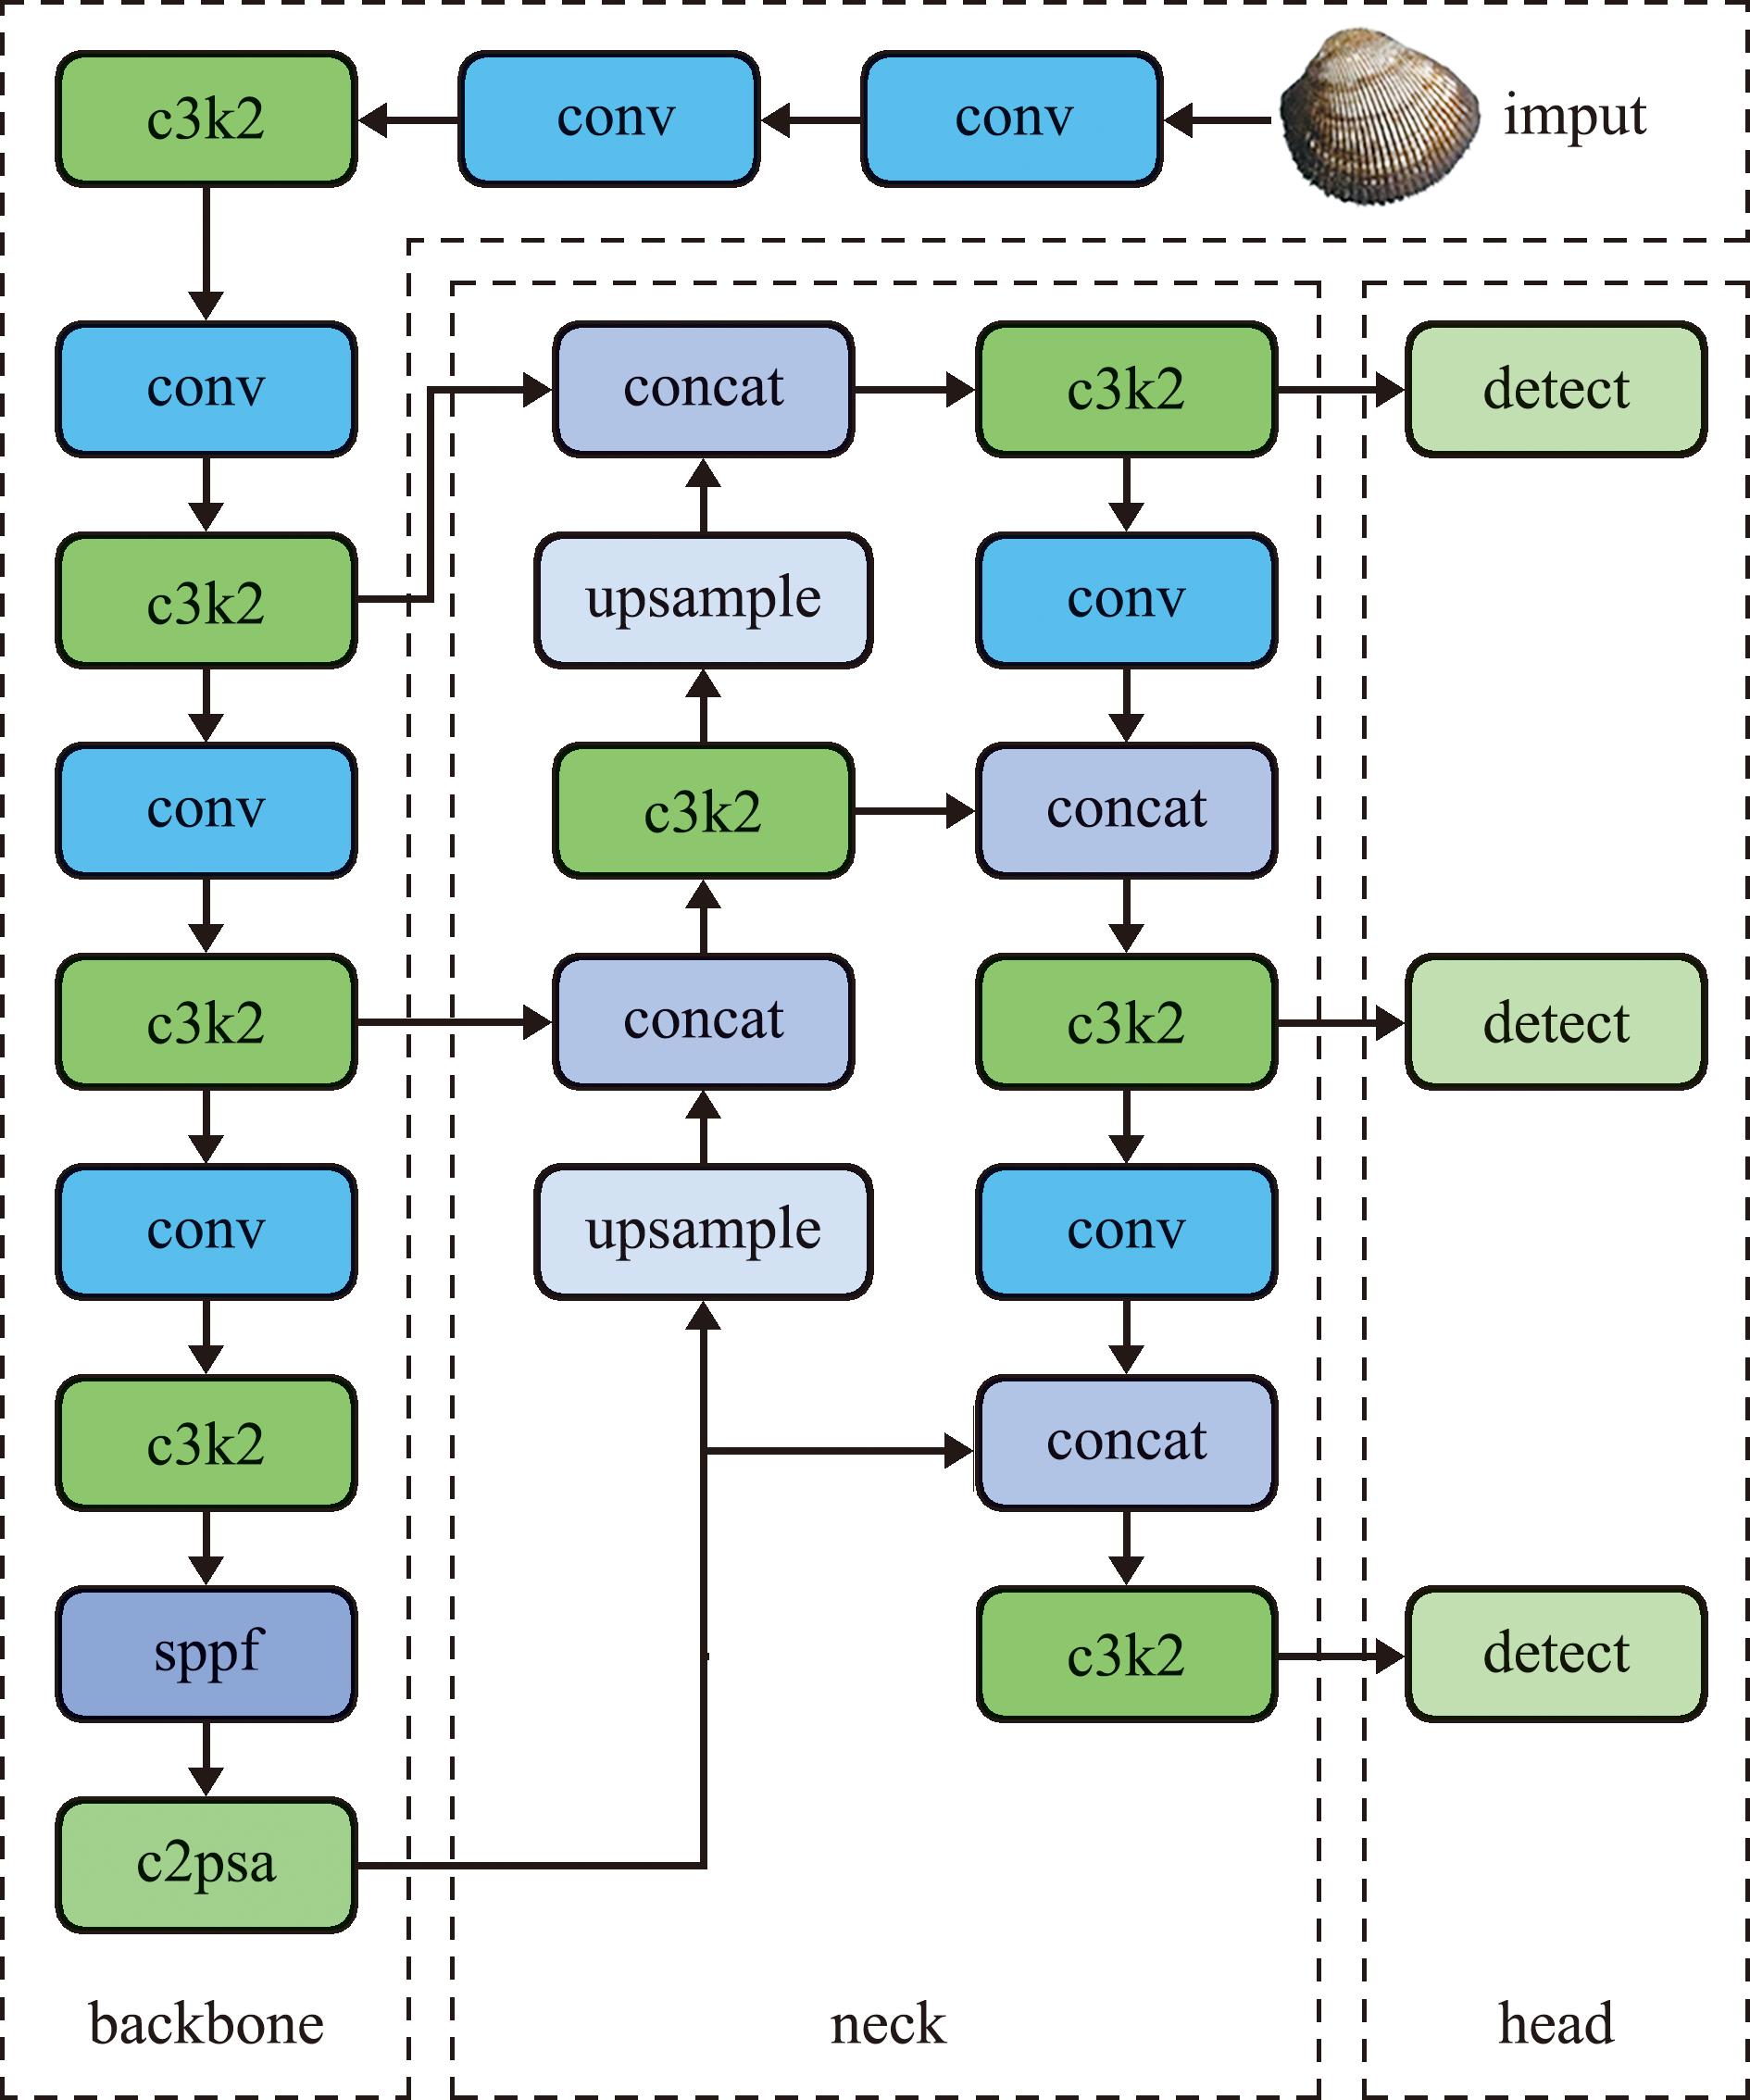
图2 YOLOv11n基础模型
Fig.2 YOLOv11n basic model
在网络结构方面,YOLOv11进行了关键性改进,传统的C2f模块升级为更具灵活性的C3k2结构;在SPPF模块之后,新增了一层基于金字塔压缩注意力机制的C2PSA模块。综上所述,YOLOv11不仅继承了YOLO系列一贯的高效性,更通过模块化创新与结构优化,在多任务能力、计算效率与检测精度之间实现了新的突破,为本研究中复杂场景下的魁蚶目标检测任务提供了强有力的模型支撑,其在推理速度上的优势也使其非常适合部署于实际应用环境之中。
2.2 改进后的DSDC-YOLOv11n模型
针对当前魁蚶筛选过程中因环境干扰严重、个体形态多变及表面附着物影响而导致的目标识别精度低、检测效率受限等问题,本研究以YOLOv11n为基准模型,提出一种面向复杂场景的高鲁棒性、轻量化目标检测模型DSDC-YOLOv11n。该模型以提升特征表达能力、优化计算效率与增强定位精度为核心目标,从网络架构的多层级进行协同改进。在主干网络和颈部网络中引入深度可分离卷积DSConv,在显著降低模型参数量与浮点运算量的同时,减少冗余计算,提升推理效率,增强模型在边缘设备部署的适用性。在主干网络中引入SCConv重构C3k2模块,组成特征提取模块SCC3k2,实现特征通道间信息的高效交互与空间细节的增强恢复,减少了对目标冗余特征的提取。检测头部分根据动态卷积的计算思路设计了新的检测头DCHead,使卷积核权重随输入特征图动态调整,增强模型对尺度变化与形变目标的适应能力,提升复杂背景下小目标的识别稳定性。在损失函数设计方面,采用Wise-IoU替代传统的CIoU损失,通过自适应加权策略平衡难易样本的梯度贡献,缓解样本不均衡问题,显著提升边界框回归的收敛速度与定位精度。改进后DSDC-YOLOv11n的网络结构如图3所示。
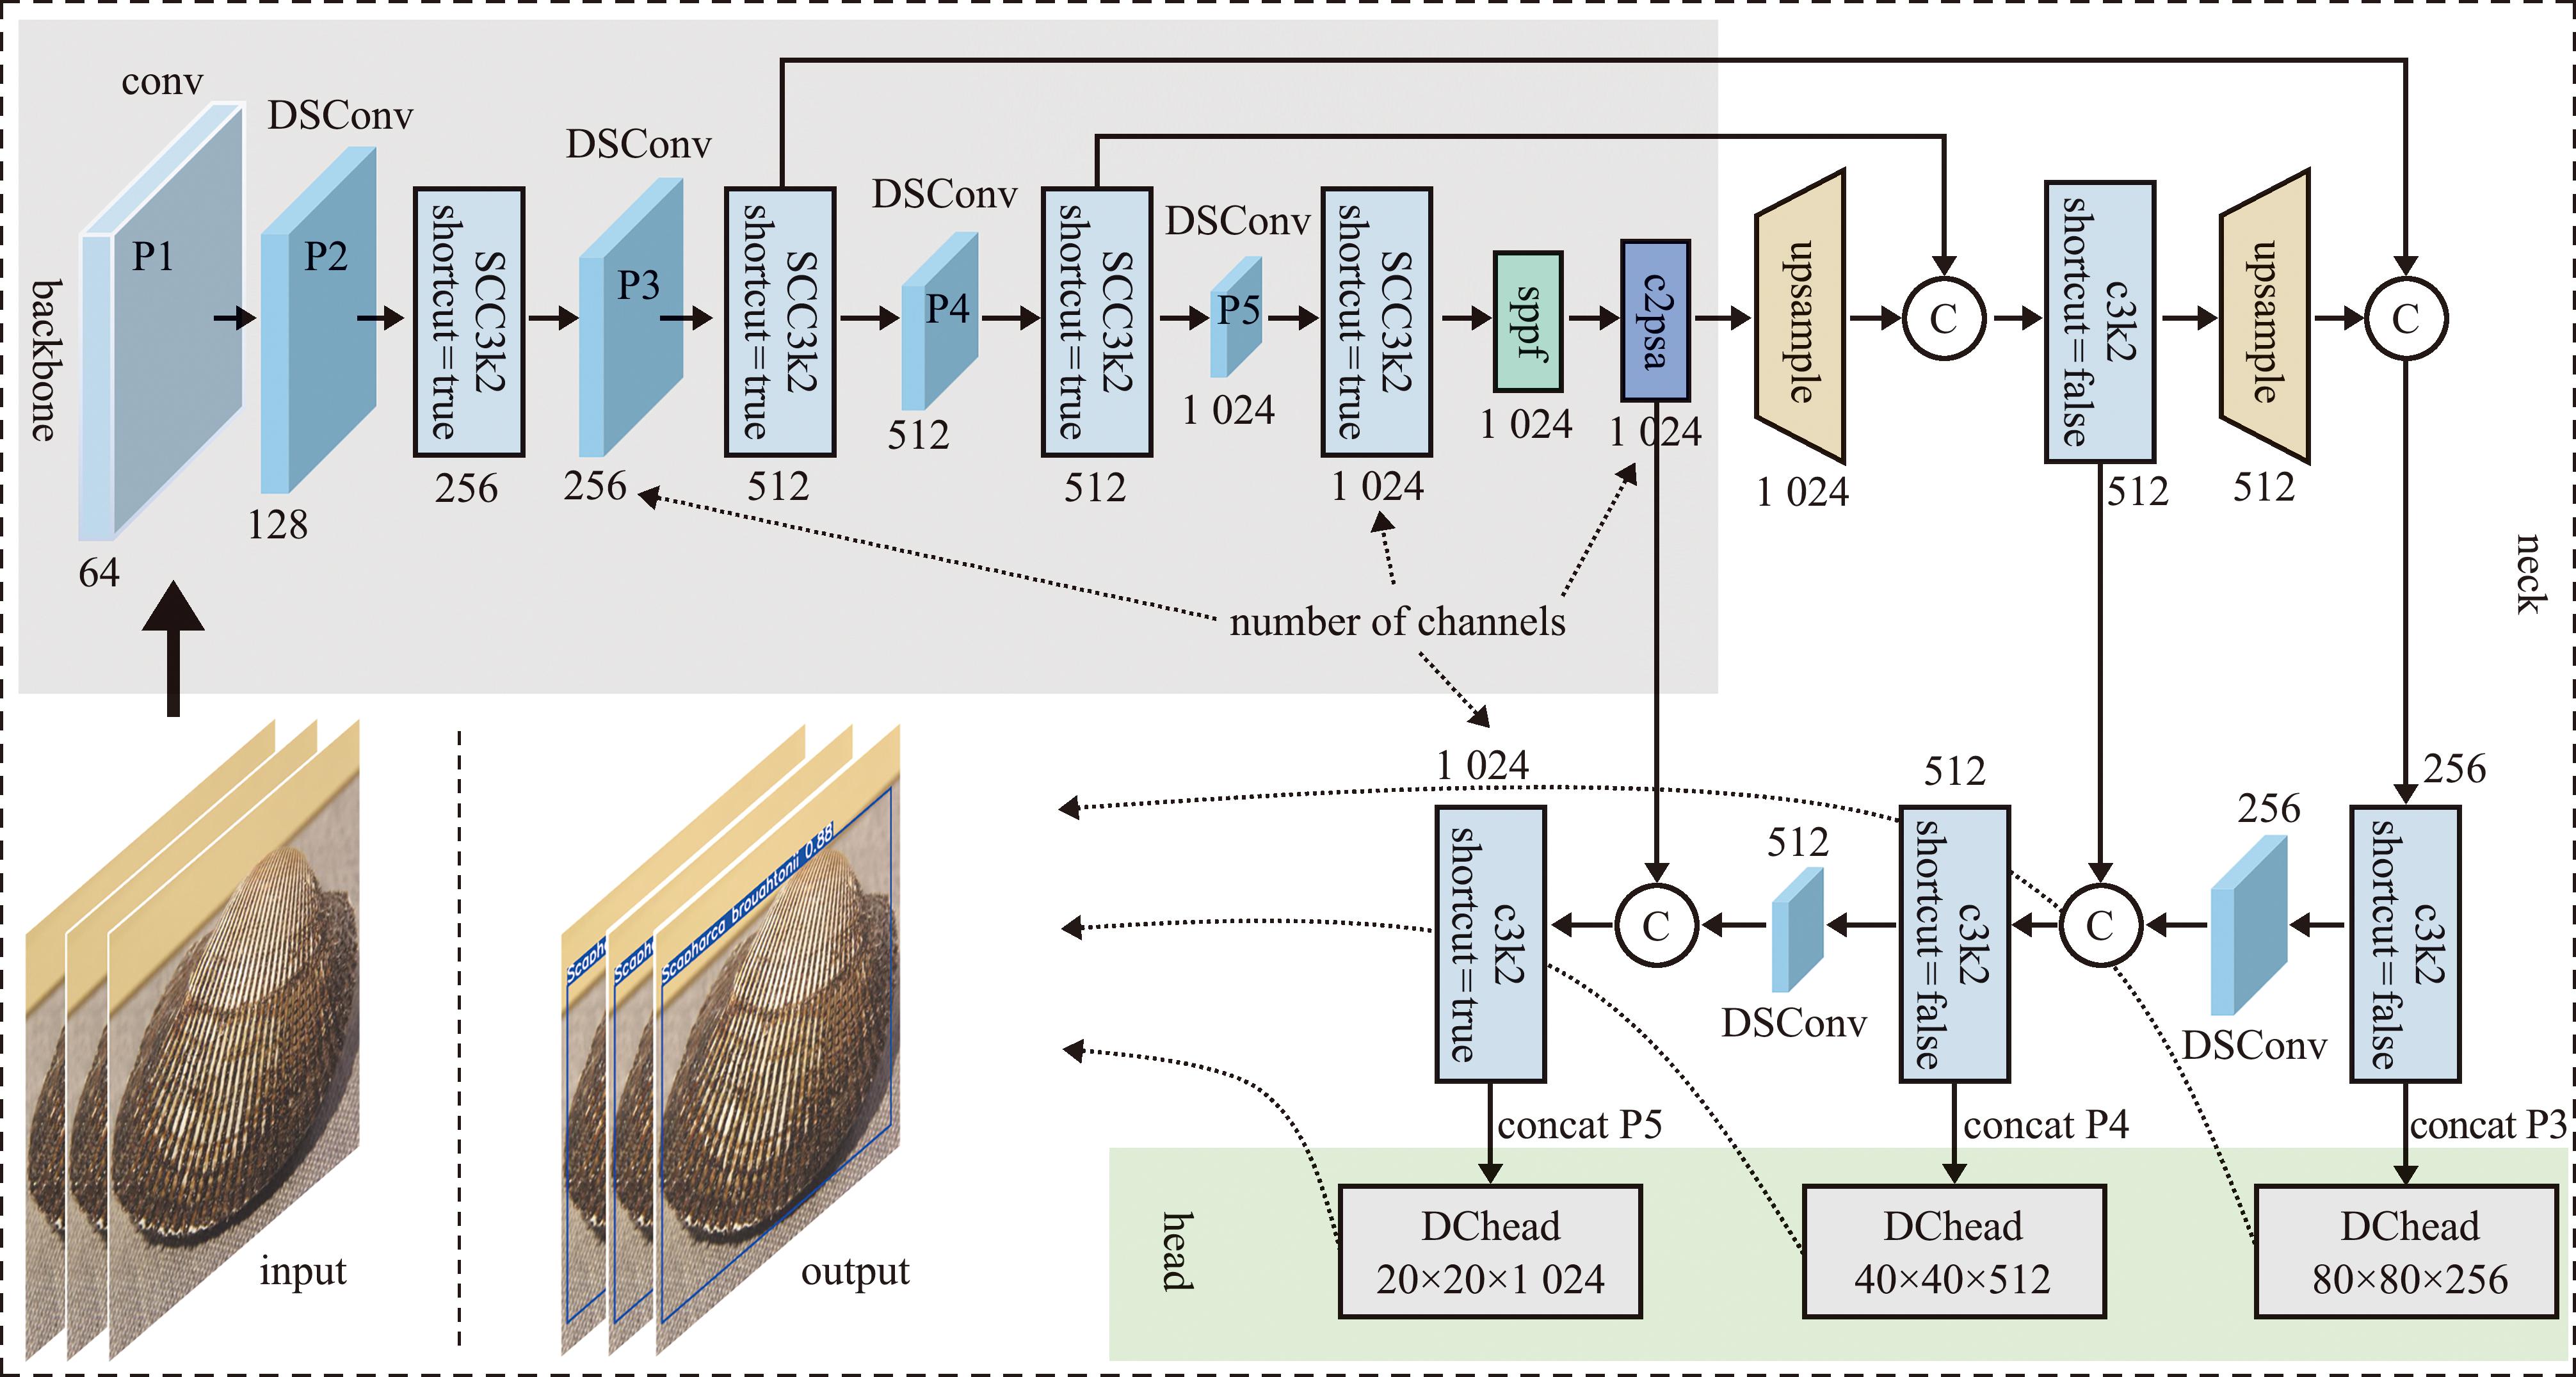
图3 DSDC-YOLOv11n的网络结构
Fig.3 Structural diagram of the DSDC-YOLOv11n network
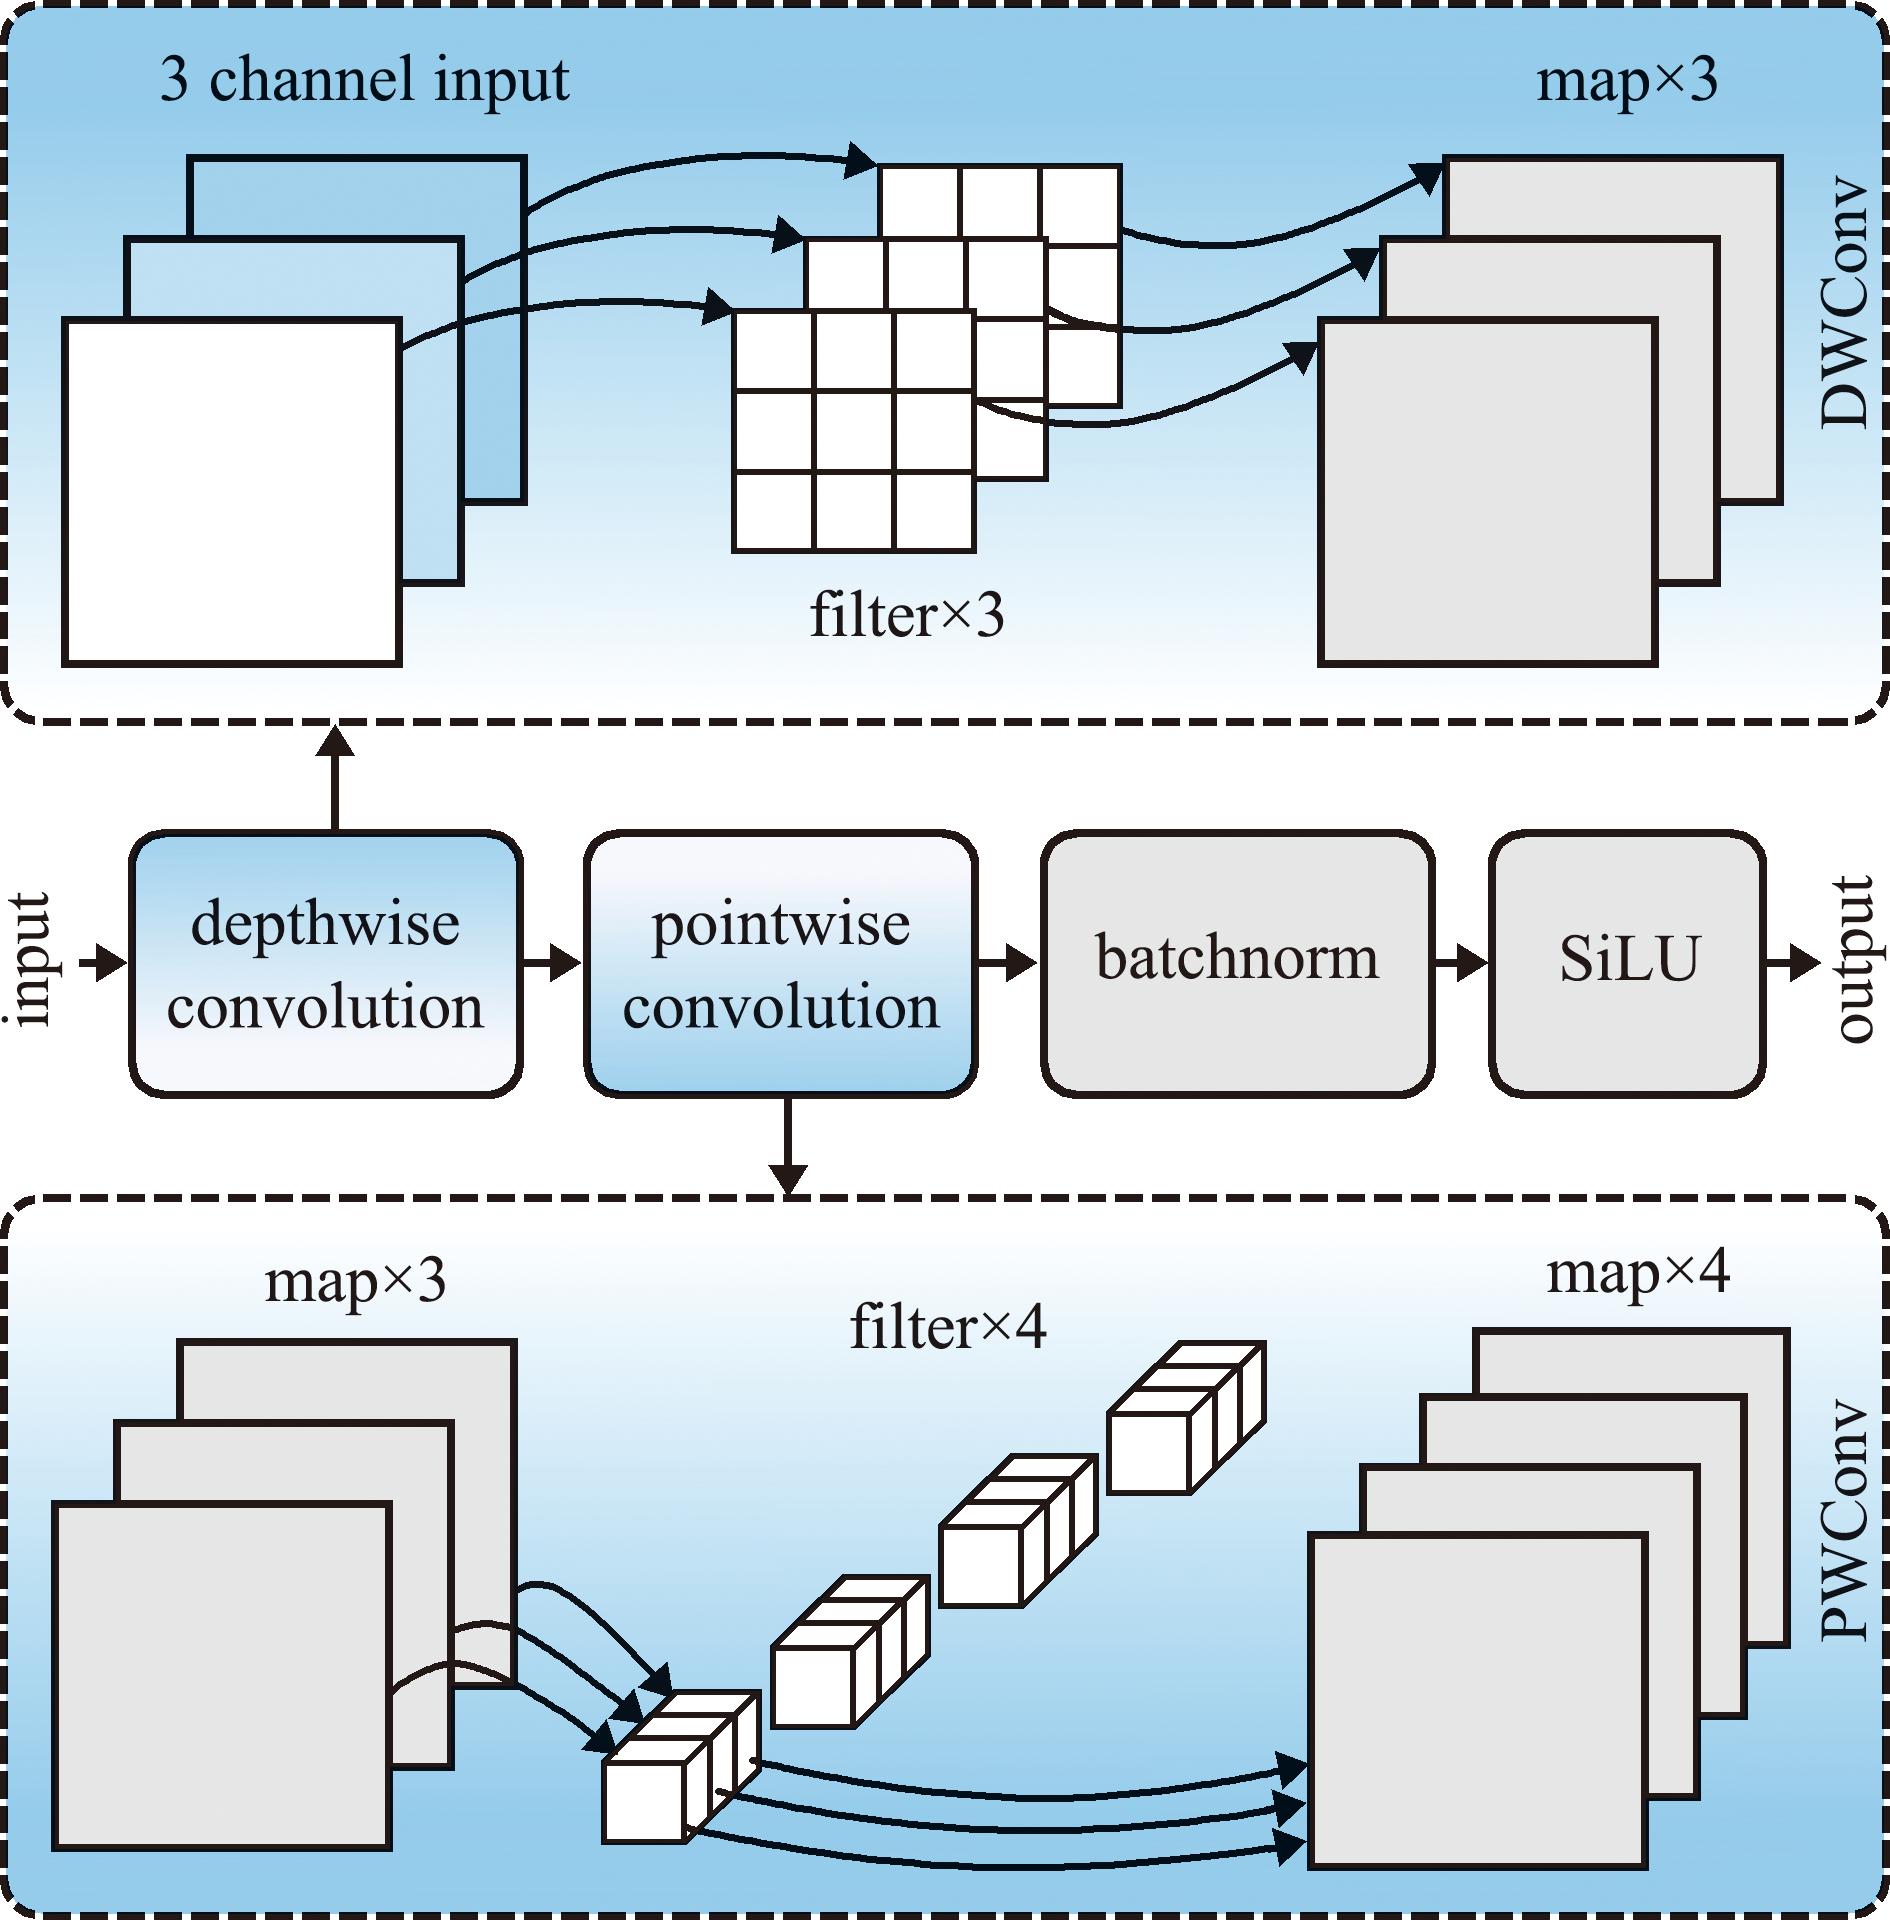
图4 DSConv工作原理
Fig.4 Working principle of the DSConv
2.2.1 DSConv模块 魁蚶实际筛选过程中存在目标轮廓模糊、特征辨识度下降等问题,传统卷积模块虽然能保持较高的识别精度,但是会带来较大的计算开销。为解决上述问题,本研究在主干网络和颈部网络中引入深度可分离卷积模块替换原始的卷积模块,此方法能够在保持识别精度的前提下降低计算开销。
深度可分离卷积DSConv[12]将计算拆解为深度卷积(depthwise convolution,DWConv)与逐点卷积(pointwise convolution,PWConv)两个阶段,实现空间维度与通道维度的解耦处理,有效降低参数冗余与计算开销[13]。其空间特征独立提取机制可减少通道间冗余信息的干扰,使网络在复杂背景下仍能聚焦于魁蚶的形态结构特征。同时,得益于其高效的计算特性,模型推理速度得以提升,可满足边缘设备对实时性与低功耗的部署需求,为魁蚶筛选提供了更具实用性的解决方案。
2.2.2 SCC3k2模块 在提取魁蚶的像素特征时,C3k2模块在训练过程中会提取到冗余特征,造成计算资源浪费。本研究在C3k2模块中引入空间与通道重建卷积(SCConv)[14]组成SCC3k2,以减少冗余特征提取,提升模型目标检测准确性[15]。C3k2模块的瓶颈结构由n个特征提取模块组成,其中每个模块由两个卷积模块组成,如图5(a)所示,SCC3k2模块的瓶颈结构采用SCConv替换原始的卷积结构以减少冗余的特征提取,如图5(b)所示。
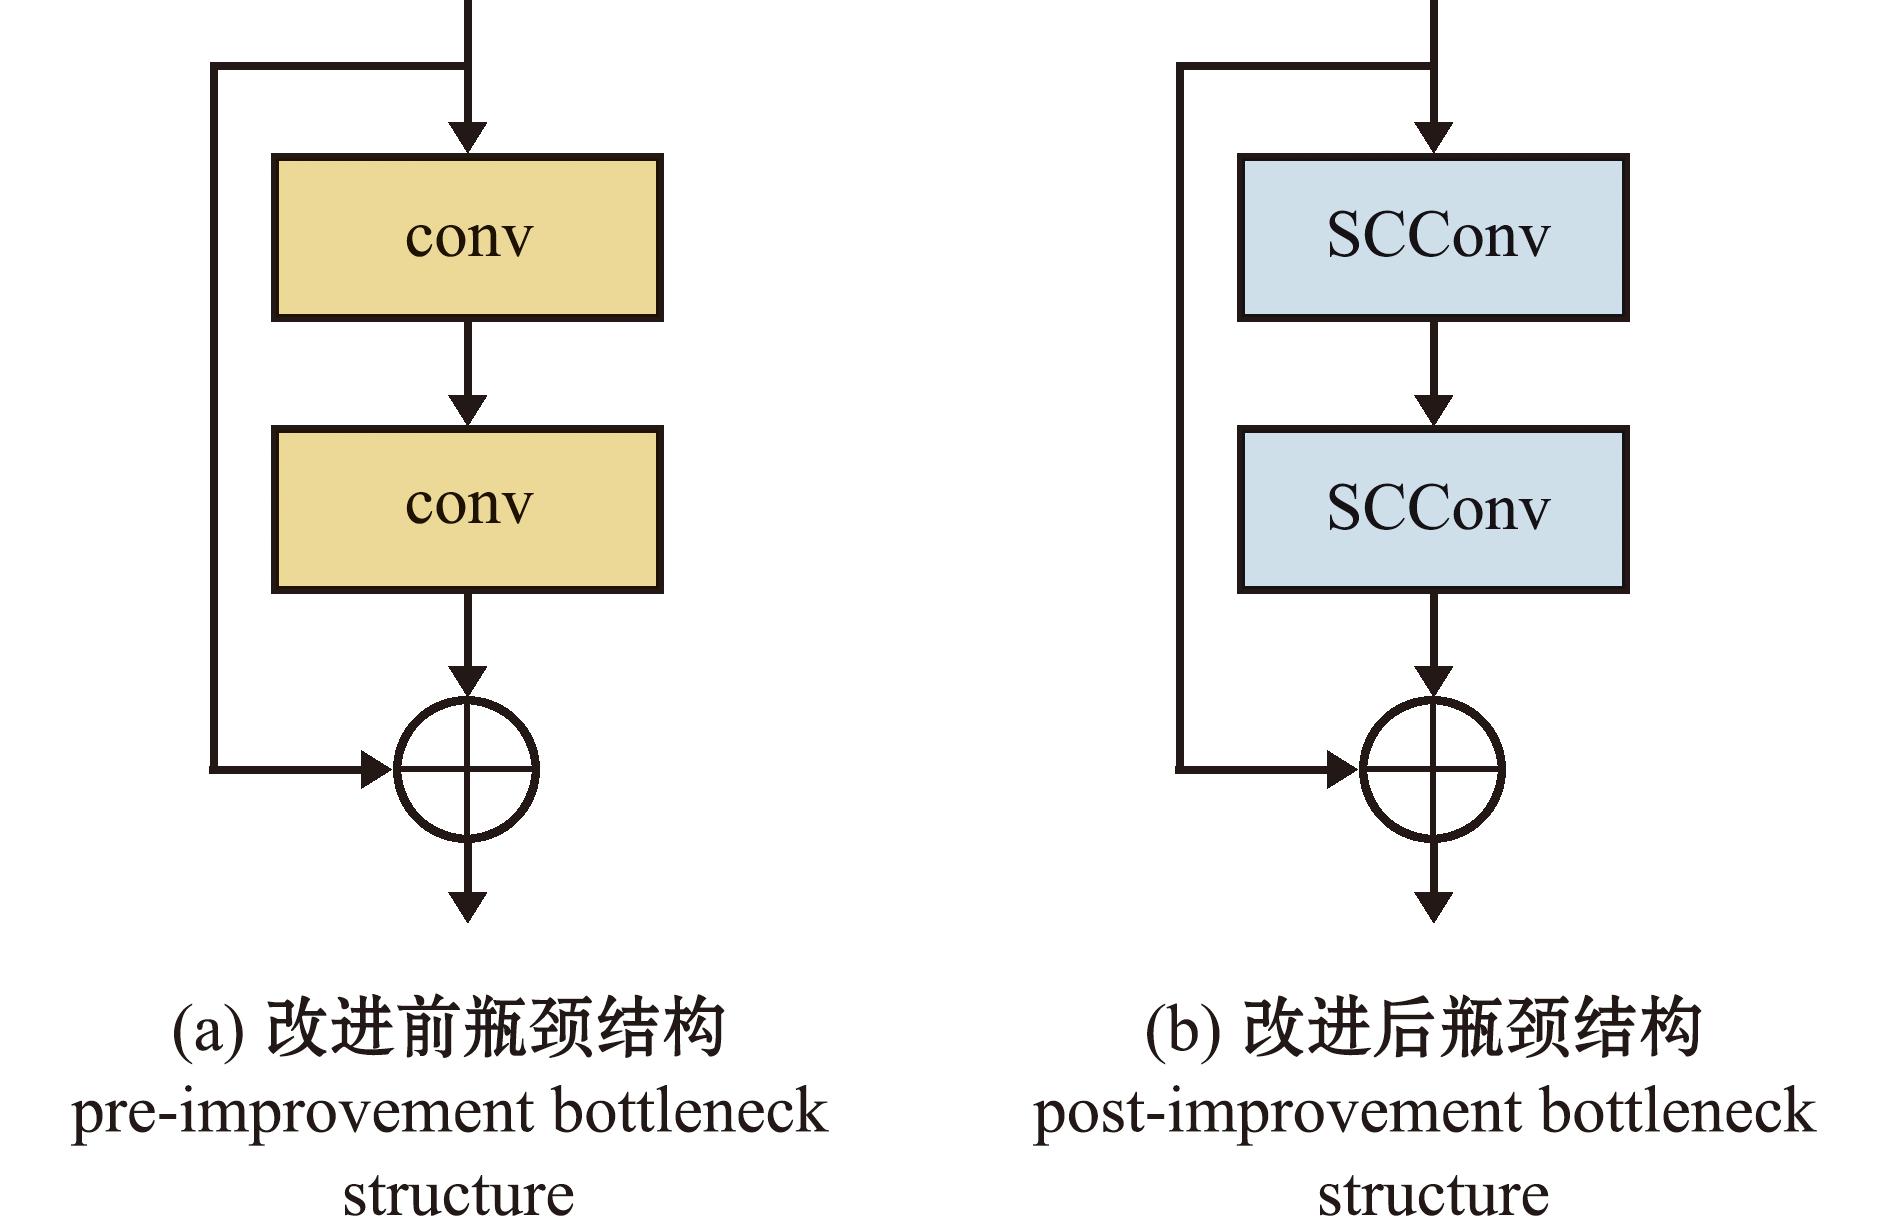
图5 瓶颈结构对比
Fig.5 Comparison of bottleneck structure
从图6可见,SCConv由空间重建单元(spatial reconstruction unit,SRU)和通道重建单元(channel reconstruction unit,CRU)组成。
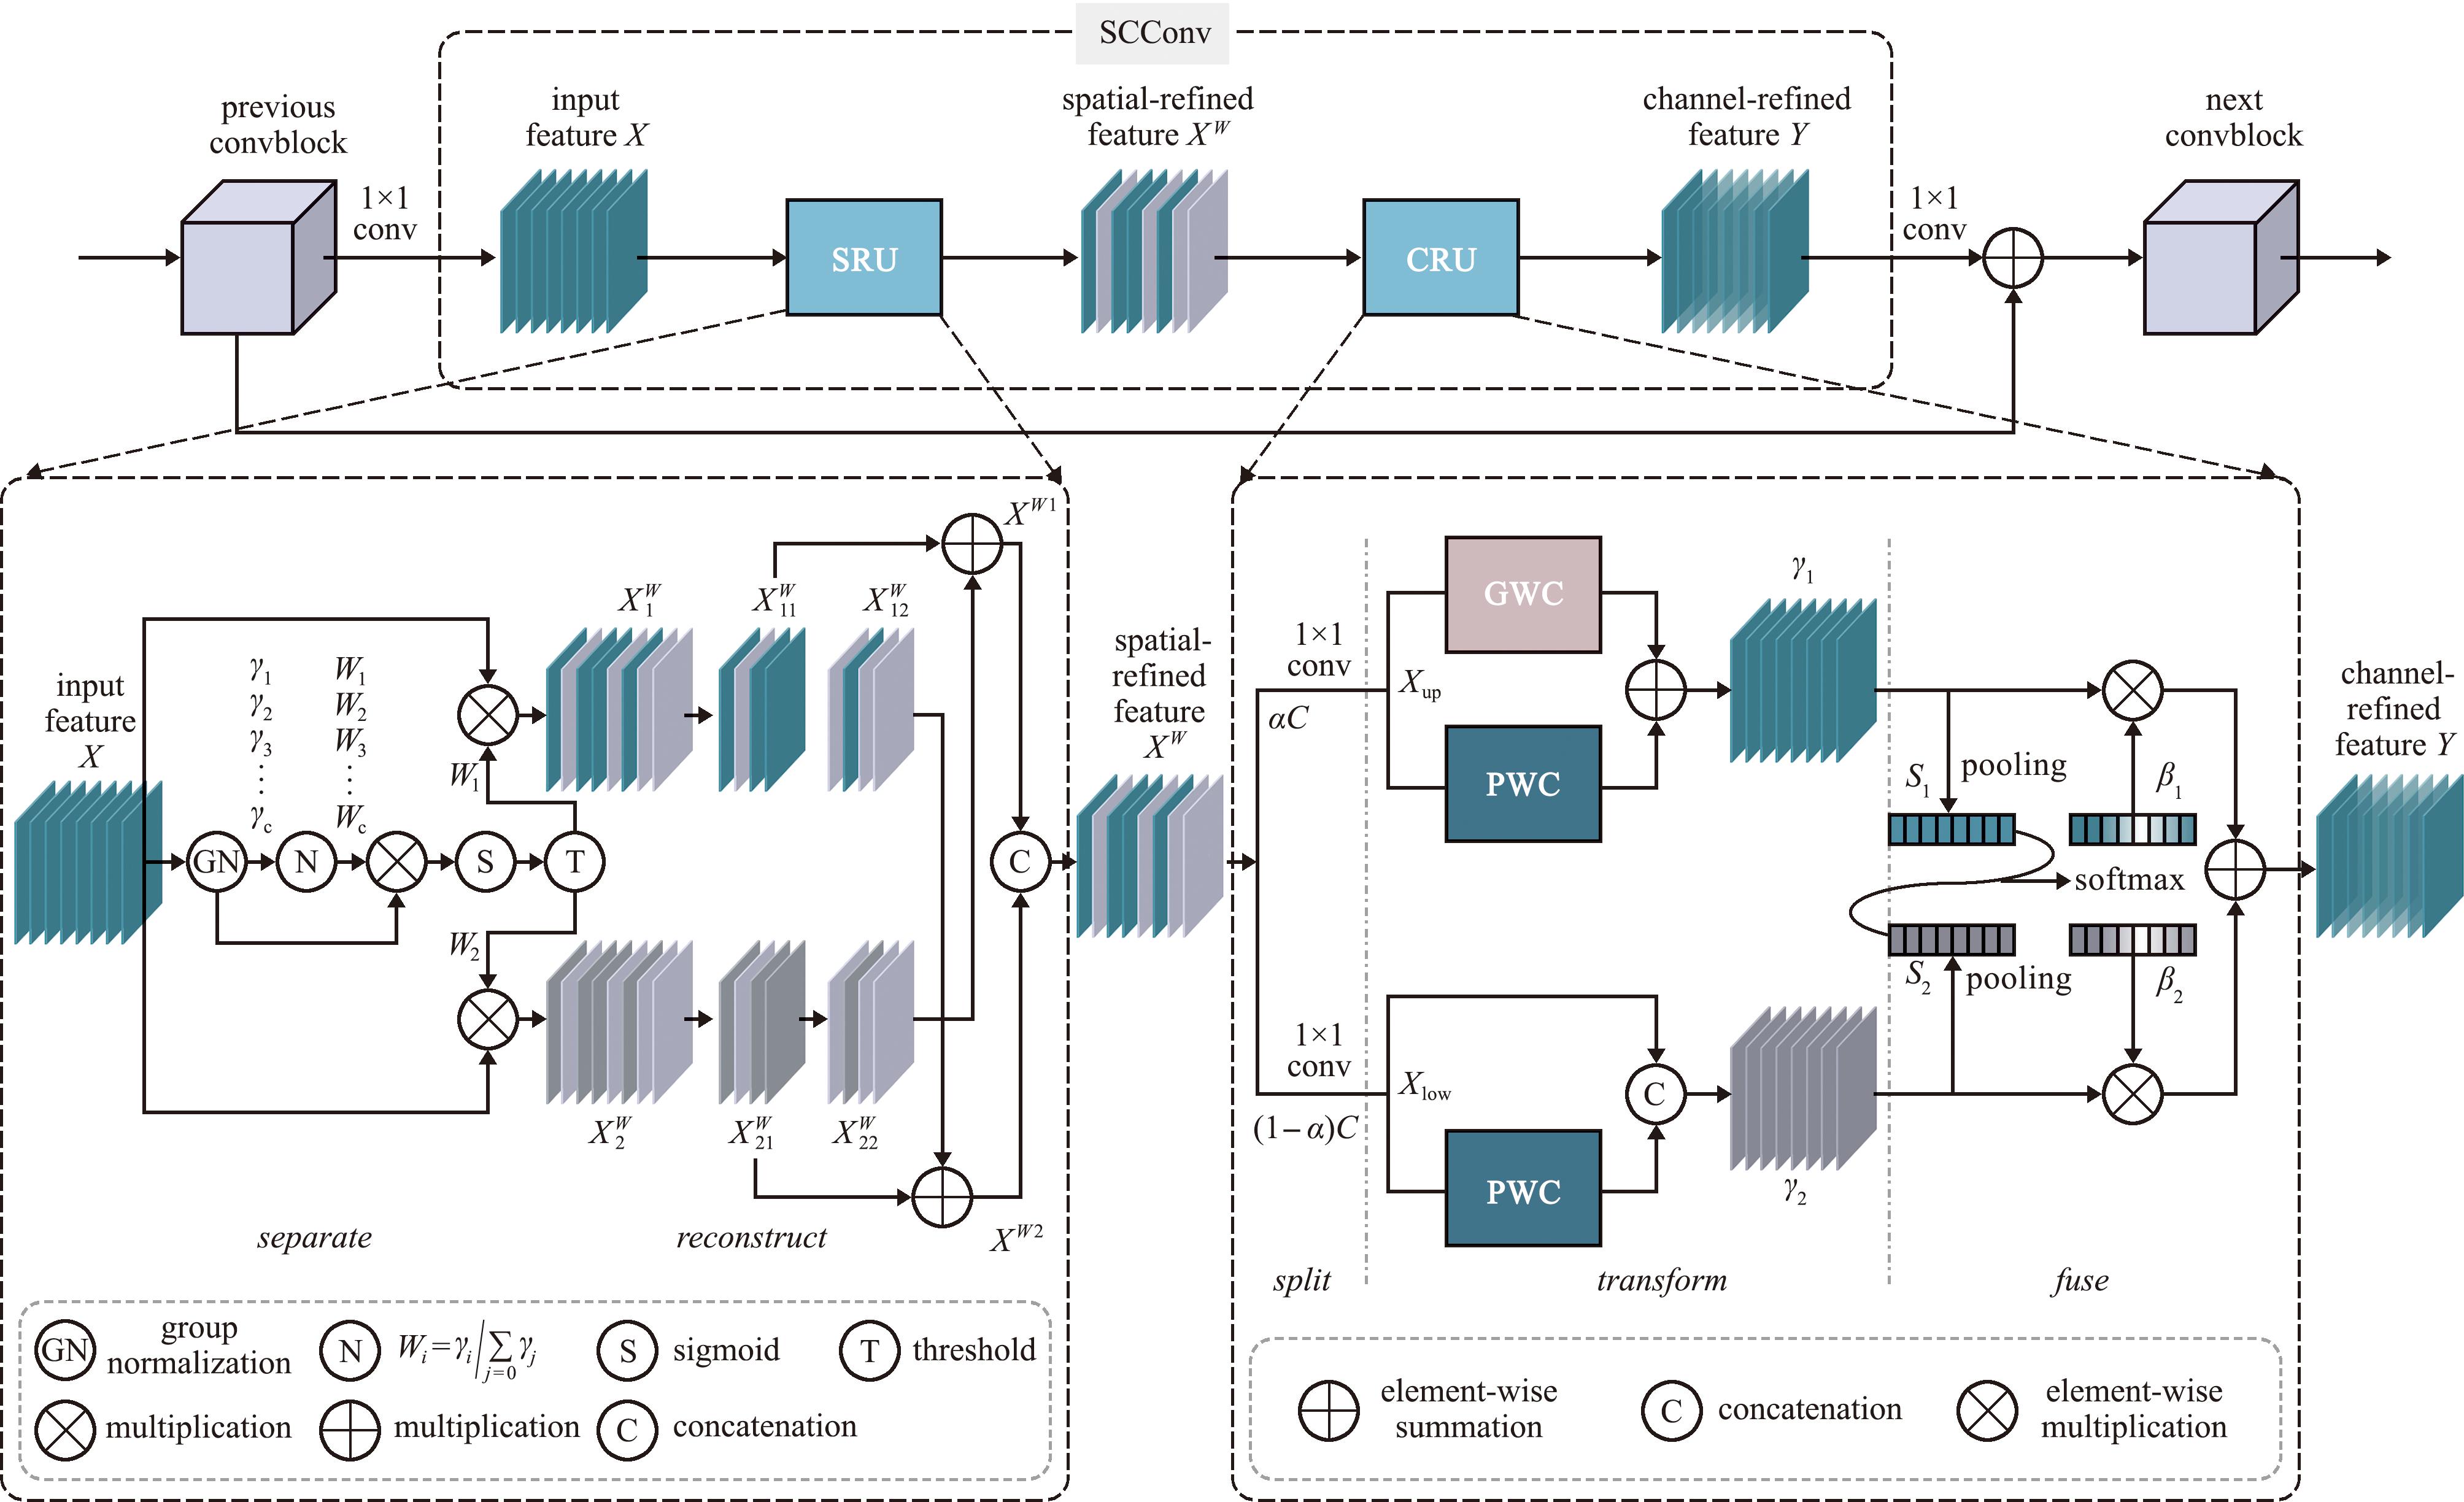
图6 SCConv模块结构
Fig.6 Structural diagram of the SCConv module
SRU采用分离重构的方法来抑制图像中冗余的空间信息,CRU采用分离变换融合的策略来减少图像中冗余的信道信息[16]。在SRU中分离阶段依据特征图的空间信息密度进行判别,将高信息量区域与低信息量区域解耦。为增强特征的判别性与稳定性,首先通过组归一化(group normalization,GN)层对输入特征图标准化处理,利用其可学习的缩放因子对特征通道进行自适应归一化,具体过程如式(1)所示。
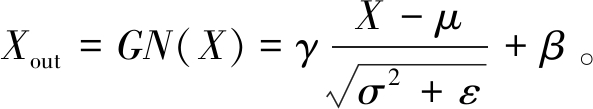
(1)
式中:μ和σ分别为X的均值和标准差;ε为一个为了稳定除法而添加的小的正数;γ和β为可训练参数。接着在GN层中使用可训练参数γ∈RC来度量各批次与通道的空间像素方差,表示不同特征图重要程度的归一化相关权重,如式(2)所示。
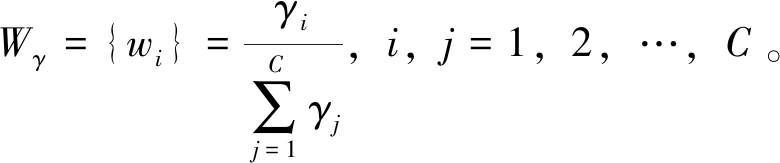
(2)
通过Sigmoid门控机制对权重进行信息密度划分,输入特征X与高信息权重W1和低信息权重W2逐元素加权,生成高表征性特征 与冗余特征
 实现空间维度的特征选择。重建过程首先对和
 进行分组交叉相加,生成紧凑特征;随后将和通道拼接,得到空间细化特征图,如式(3)所示。
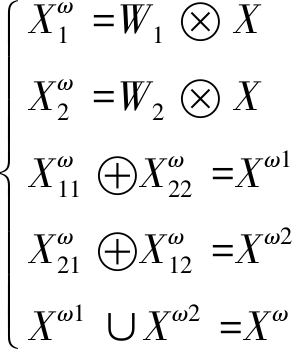
(3)
式中:⊗为逐元素乘法;⊕为逐元素加法;∪为拼接操作。
CRU用来限制特征的通道冗余,Xω按通道维度被划分为两部分,其通道数分别为αC和(1-α)C,分别记为上支路特征Xup与下支路特征Xlow。随后,通过1×1卷积对二者进行通道压缩,以降低计算开销并增强特征紧凑性。在特征转换过程中,上支路Xup经由分组卷积(group-wise convolution,GWC)与逐点卷积(point-wise convolution,PWC)的级联操作,提取高层语义表征并生成高阶语义特征Y1,同时有效减少模型参数量与计算复杂度。下支路Y2则通过PWC操作进行线性变换,保留浅层空间细节信息,并与其原始特征进行通道拼接,形成包含细节补充信息的增强特征图Y2。在特征融合阶段,为进一步增强全局上下文感知能力,对Y1和Y2分别或联合引入全局平均池化操作(global average pooling),以聚合空间维度的统计信息,生成全局描述参数Sm,其具体计算方式如式(4)所示。
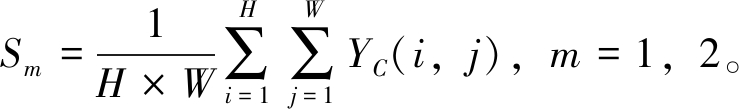
(4)
随后,将上下分支的全局描述参数S1和S2沿通道维度拼接,利用通道维度的注意力操作计算特征重要性向量β1和β2,过程如式(5)所示。
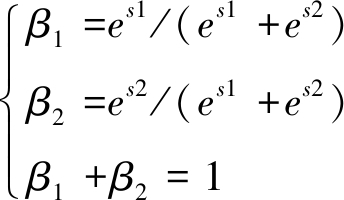
(5)
最终,通过通道维度的特征融合机制整合上支路特征Y1与下支路特征Y2,生成通道精细化特征Y。得益于SCConv在保持特征提取完备性的同时显著降低模型参数量的特性,嵌入该模块的C3k2结构在提升网络表征能力的基础上,有效实现了模型的轻量化与计算效率的优化。
2.2.3 DCHead检测头 魁蚶筛选工作常处于背景复杂的环境中,采用原始的检测头识别难度较大且易出现误检情况,为解决该问题,本研究基于动态卷积(dynamic conv)[17]的设计思路对原始的检测头进行改进,提出了DCHead检测头,其结构如图7所示。
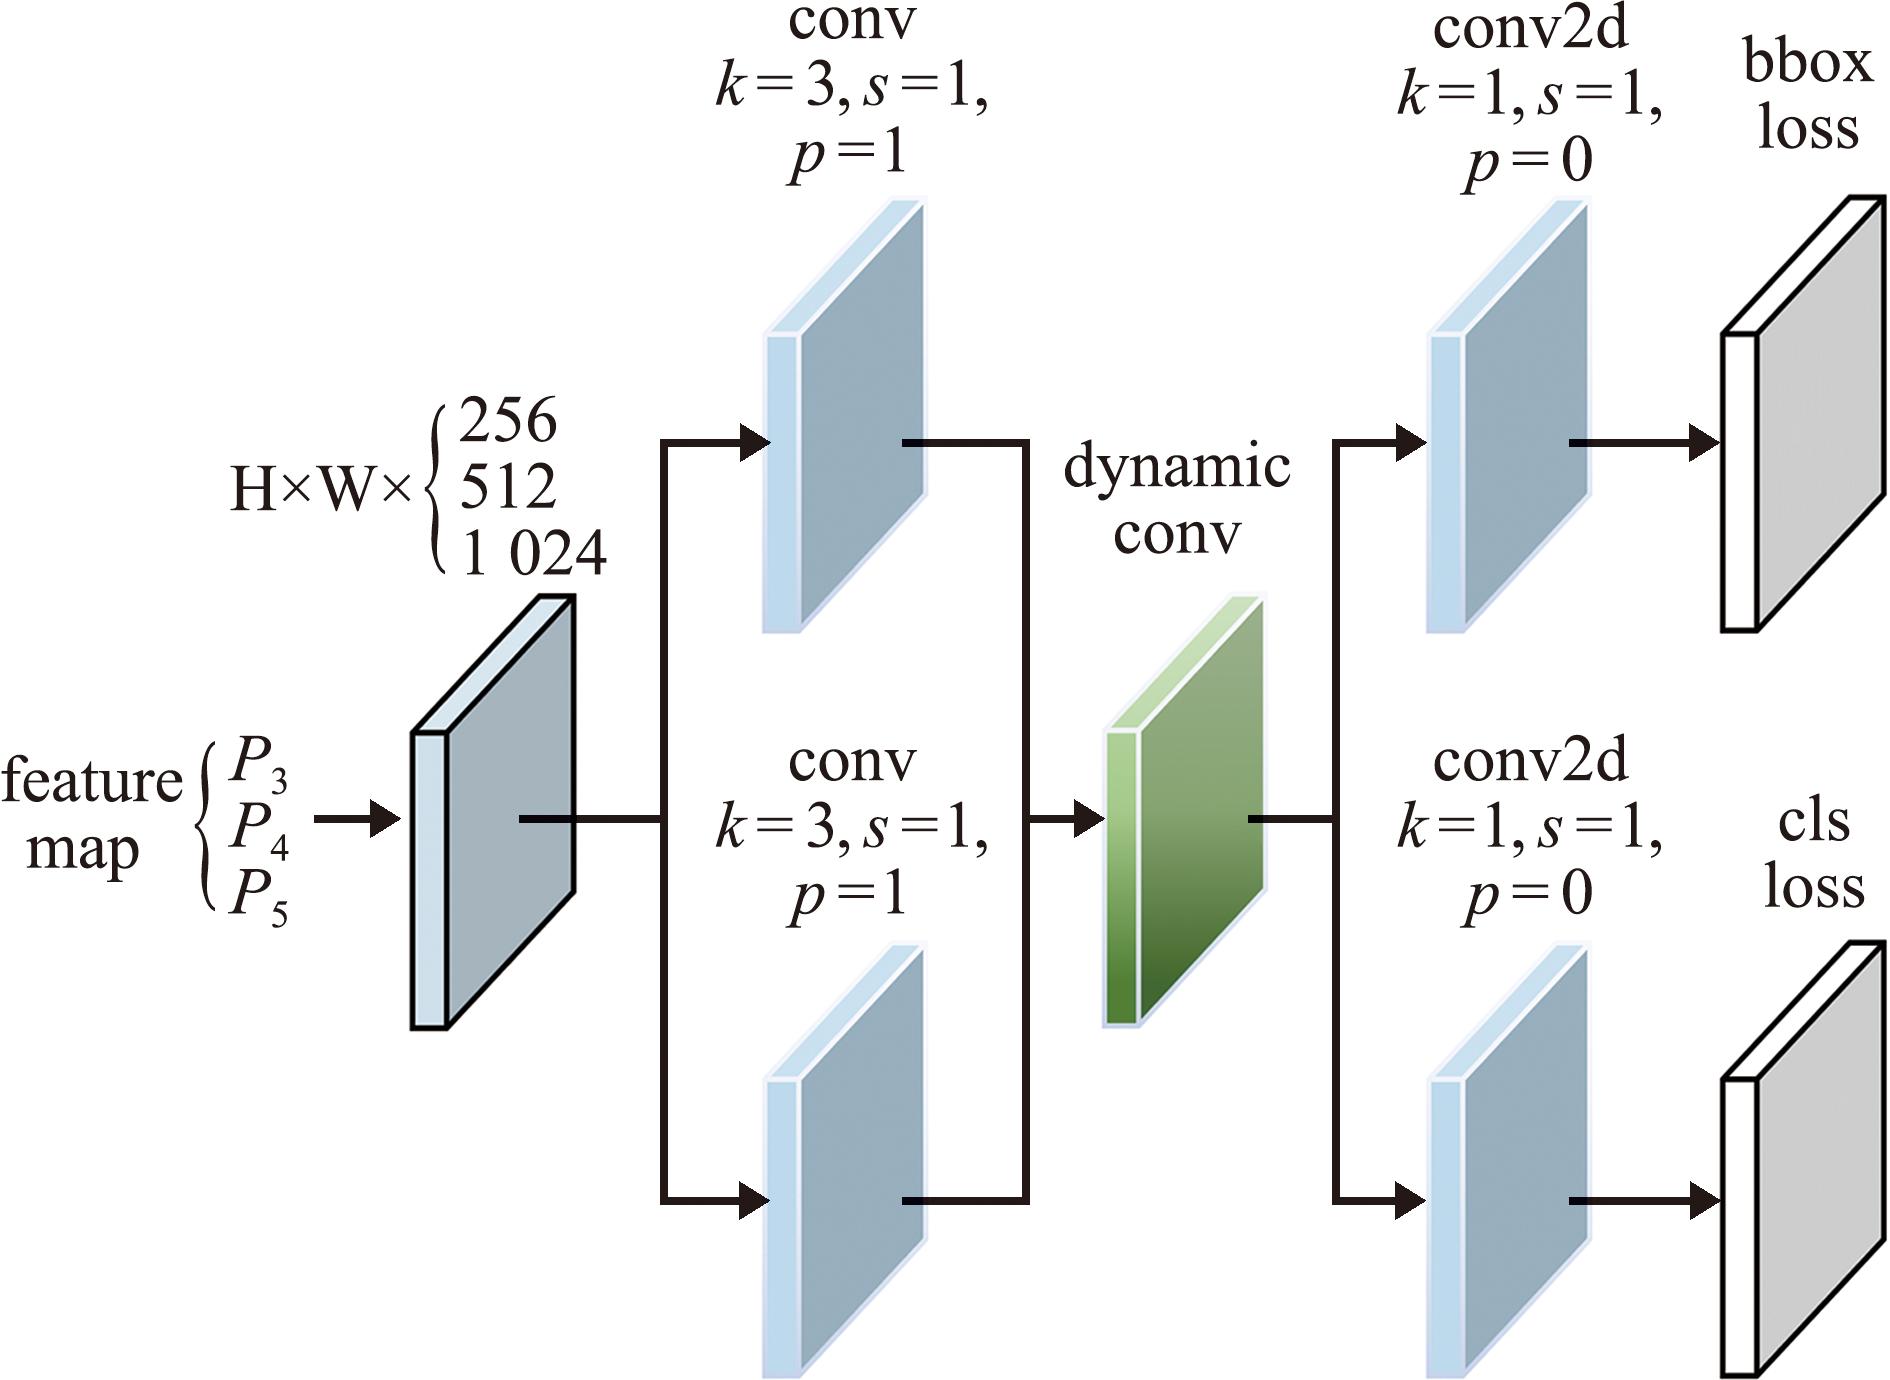
图7 DCHead检测头结构
Fig.7 Structural diagram of the DCHead detection head
Dynamic Conv的核心在于构建了一种动态参数生成机制[18],其结构如图8所示。其首先初始化M组异构卷积核,随后利用注意力网络对输入特征x进行评估,输出归一化的权重系数πm(x)。通过对各卷积核输出进行加权求和,模型能够根据当前输入内容自适应地调整卷积操作的参数配置,具体计算流程如式(6)~(8)所示。
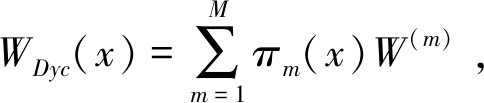
(6)
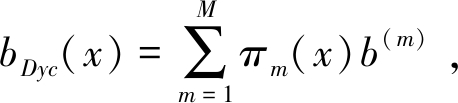
(7)
y=WDyc(x)*x+bDyc(x)。
(8)
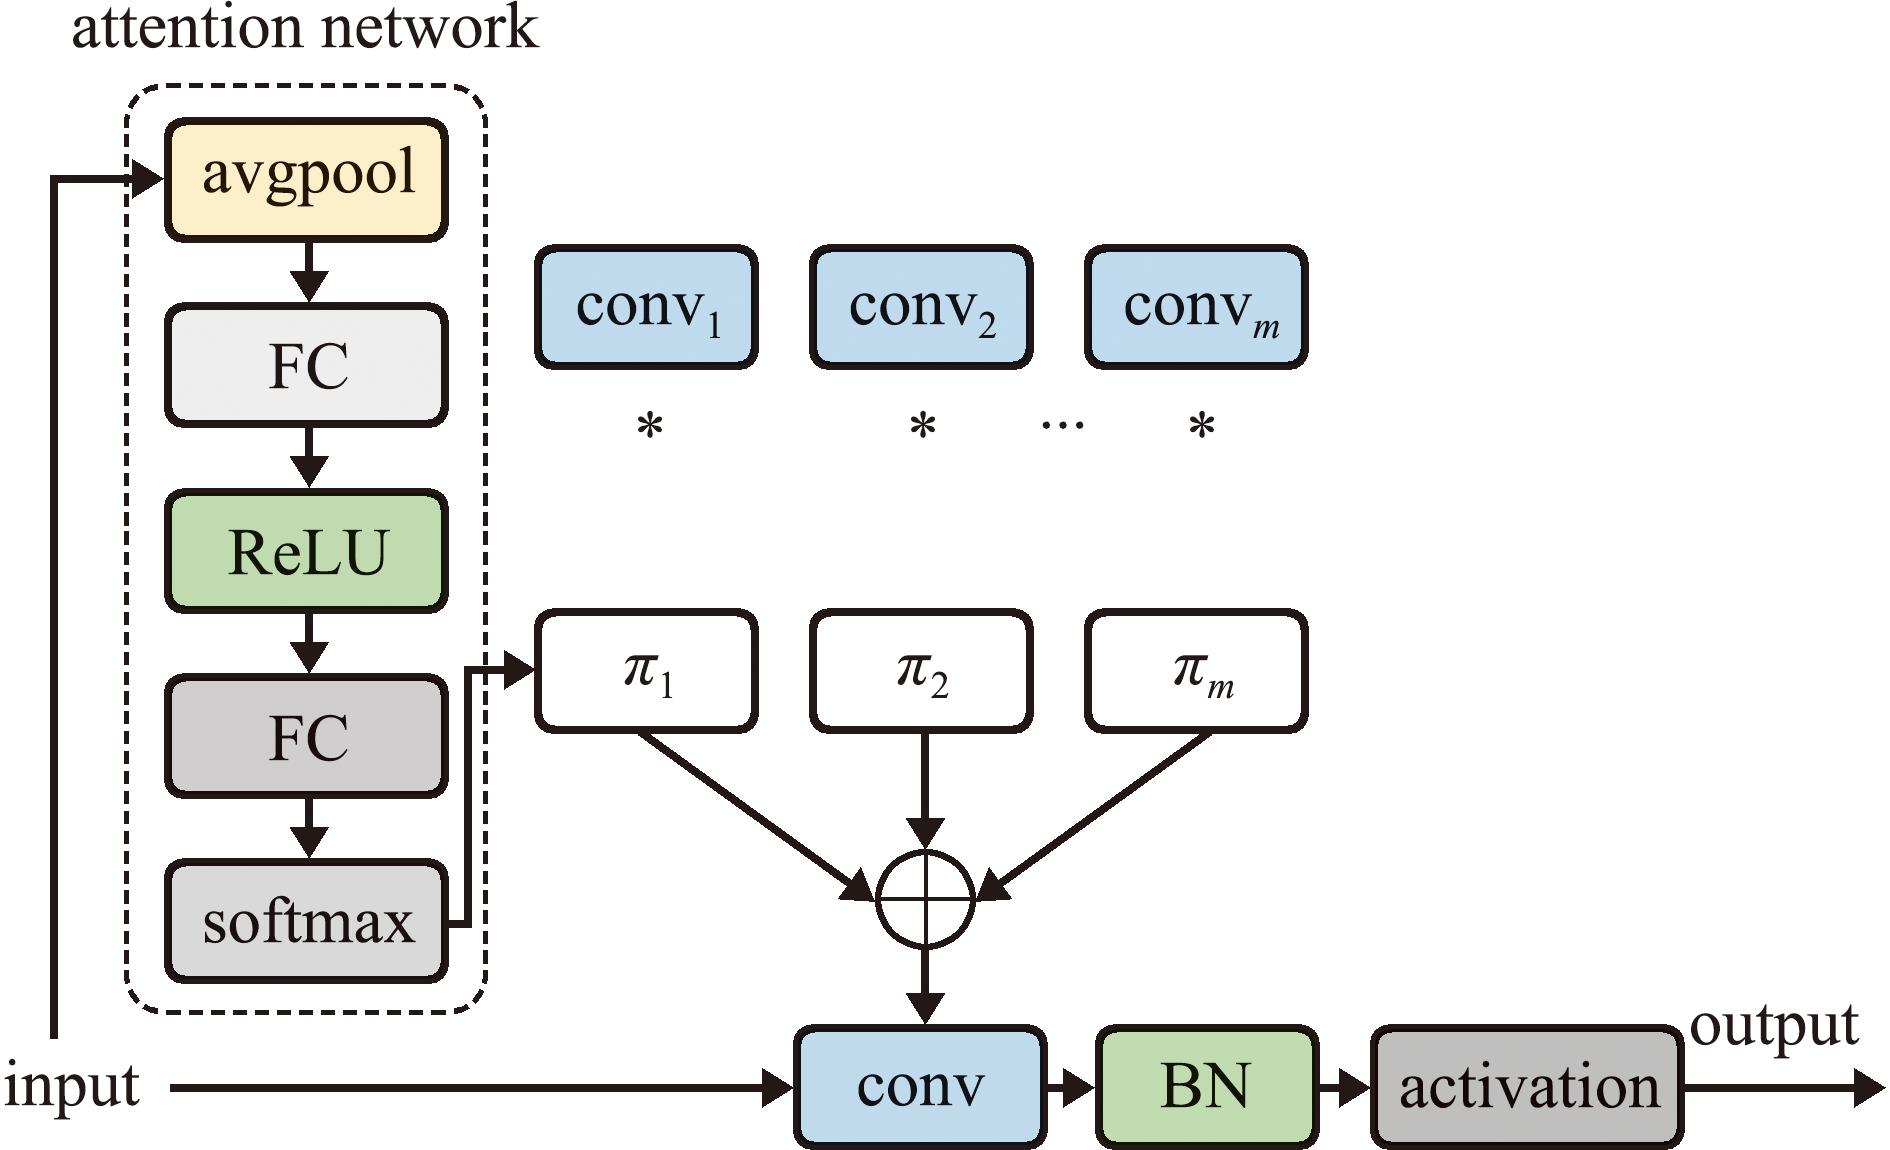
图8 Dynamic Conv结构
Fig.8 Structural diagram of Dynamic Conv
式中:WDyc(x)为动态生成的权重矩阵;M为预设的卷积核个数;πm(x)为输入相关的注意力权重;W(m)为第m个基础权重矩阵;bDyc(x)为动态生成的偏置向量;b(m)为第m个基础配置向量;*为矩阵乘法。
从图8虚线框内可见,权重系数πm(x)由一个注意力网络生成。该网络首先对输入特征x执行全局平均池化操作,以聚合上下文信息并生成全局描述参数S;随后,将S输入至一个包含非线性激活函数(ReLU)的两层全连接网络FC(fully connected)中进行特征映射;最终,通过Softmax函数对输出结果进行归一化处理,生成注意力权重πm(x)。该计算流程的具体数学表达如式(9)所示。
z=W2Relu(W1z+b1)+b2,z∈RM。
(9)
式中:W1和W2为权重向量;b1和b2为偏置向量;z为一个输出向量;M为输出向量的维度。
2.2.4 Wise-IoU损失函数 试验获取到的图像中魁蚶姿态各异,在标注数据集时标注框中难免会存在面积不同的背景,进而导致模型学习的样本质量存在差异。如果强化对低质量边界框的回归,则会危害模型的检测性能[19-20]。因此本研究中引入具有动态非单调聚焦机制的Wise-IoUv3[21]作为损失函数,以代替原本的CIoU损失函数。改进后的模型在训练过程中能够更好地适应不同质量的样本,并能更准确地定位目标。通过Wise-IoUv3的应用,增强了模型的泛化能力和鲁棒性,进一步提高了魁蚶检测的性能和稳定性。IoU用于测量目标检测任务中预测框和真实框之间的重叠程度,定义如式(10)所示。
LIoU=1-IoU=1-(WiHi)/Su。
(10)
式中:Wi为预测框和地面真实框之间交集区域的宽度;Hi为预测框和地面真实框之间交集区域的高度;Su为预测框和真实框的并集区域。同时,IoU有一个致命的缺陷,当边界框之间无重叠时(Wi=0或Hi=0),损失函数的梯度LIoU在反向传播期间消失,导致在训练期间无法更新重叠区域Wi的宽度。如式(11)所示。
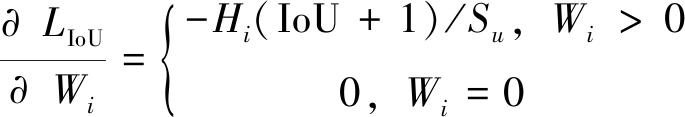
(11)
从图9可见,Wise-IoU包含3个演进版本(Wise-IoUv1、v2和v3)。其中,Wise-IoUv1针对训练数据集中不可避免存在的低质量样本问题,构建了基于距离度量的双层注意力机制,旨在抑制此类样本对模型泛化性能的负面影响,如式(12)和(13)所示。
LWIoUv1=RWIoULIoU,
(12)
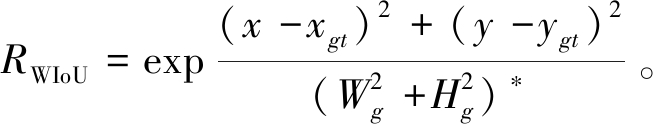
(13)
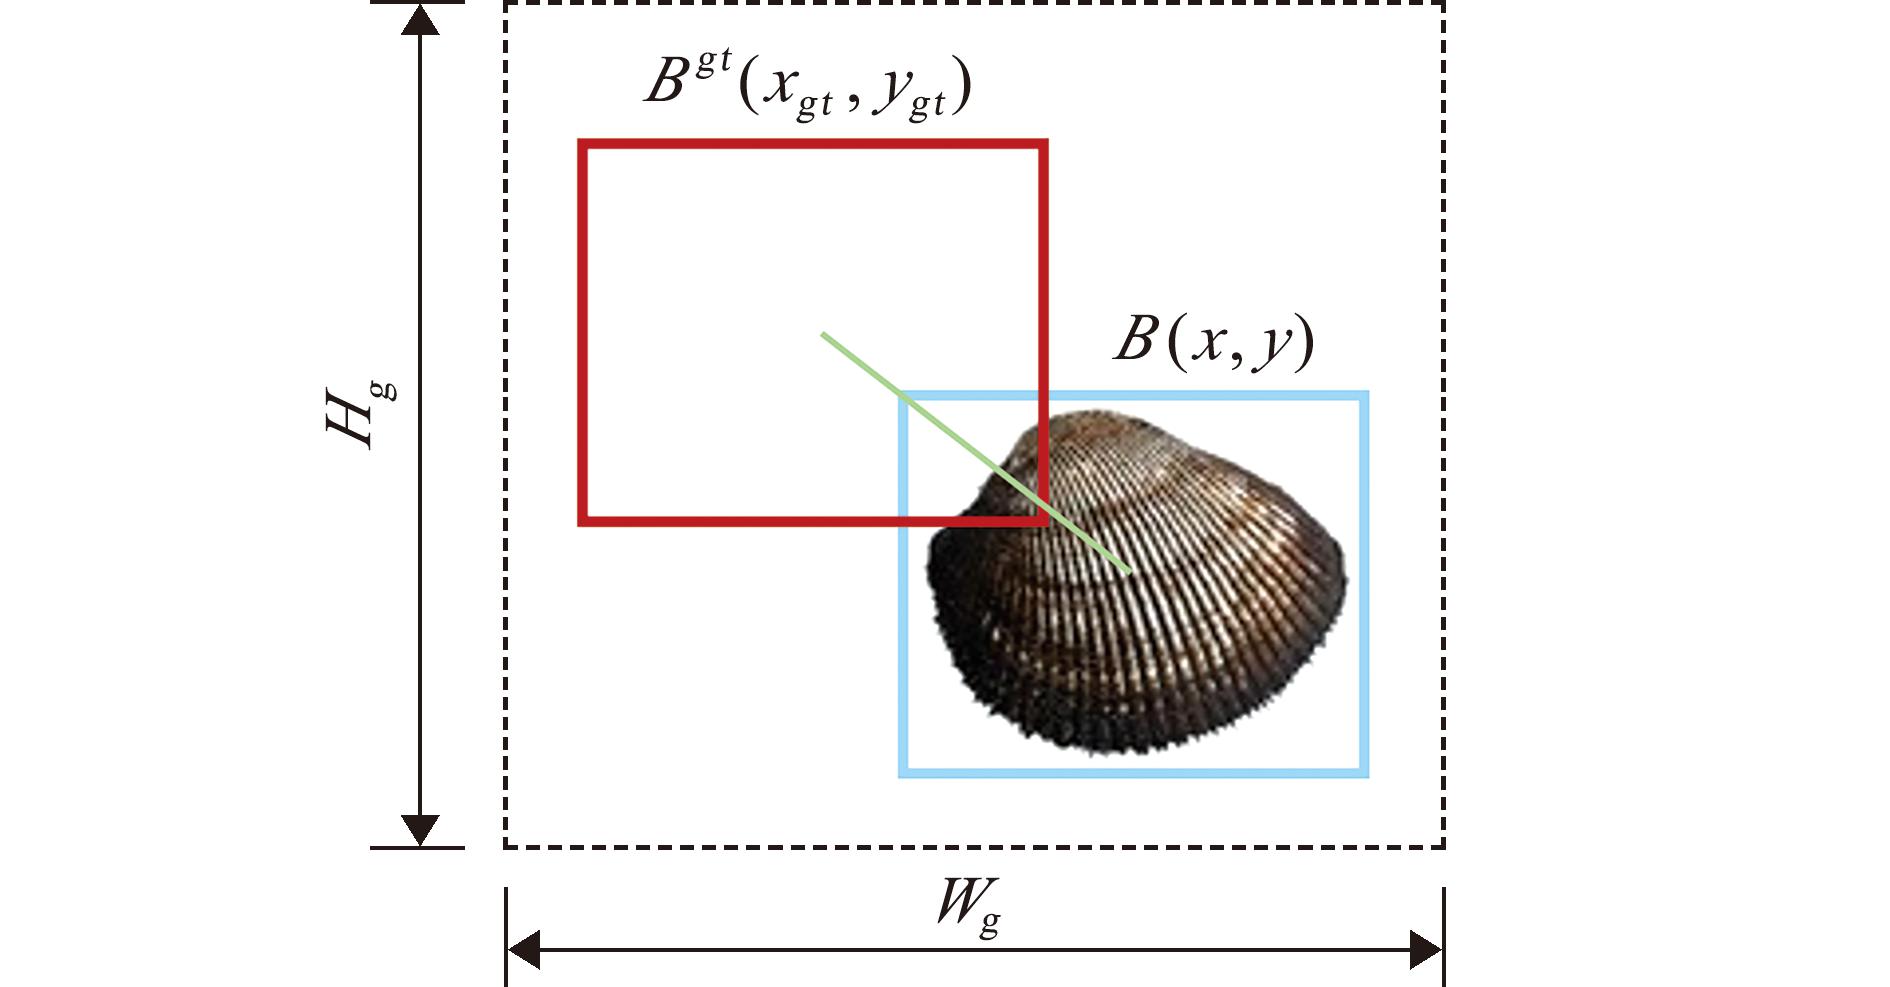
图9 Wise-IoU示意图
Fig.9 Wise-IoU schematic
Wise-IoUv2受Focal Loss启发,在Wise-IoUv1的基础上引入了单调聚焦系数。该机制通过降低简单样本对总损失的贡献度,引导模型在训练过程中更加关注难例,从而有效提升了分类性能,其定义如式(14)所示。
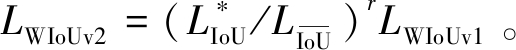
(14)
Wise-IoUv3在Wise-IoUv1的基础上进行了进一步拓展,通过引入离群度度量β构建了非单调聚焦系数r,旨在实现更灵活的梯度增益分配,公式如下。
r=β/(δαβ-δ),
(15)
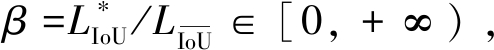
(16)
LWIoUv3=r×LWIoUv1。
(17)
式中:β为离群度,用于表征回归框的质量; 为具有动量m的滑动平均值,其动态更新机制确保了整体β维持在较高水平,有效缓解了训练后期收敛缓慢的问题。超参数α和δ用于控制聚焦机制,由于的动态特性,质量划分的基准也随之动态调整,这使得 Wise-IoUv3能够在训练过程中实时制定最优的梯度增益分配策略。
3 试验结果与分析
3.1 试验环境
本研究中使用的操作系统为Microsoft Windows 11,CPU型号为Intel(R)Core(TM)i7-13700KF@3.7GHz,GPU型号为12GB显存的NVIDIA GeForce RTX 4070 Super。深度学习框架为PyTorch 2.4.1,CUDA版本为12.4,系统整体编写语言版本为Python 3.11。试验时采用学习率为0.01的随机梯度下降优化器来优化网络权重,动量因子设置为0.937,批量设置为16,整个训练过程进行了200次迭代。
3.2 评价指标
本研究中使用精确度P(precision)、召回率R(recall)、平均精度mAP(mean average precision)、参数量(parameters)、计算量(GFLOPs)、帧数(FPS)和模型大小(size)。其相关公式为
P=TP/(TP+FP),
(18)
R=TP/(TP+FN),
(19)
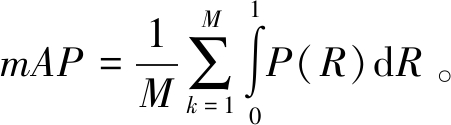
(20)
式中:TP为模型预测为魁蚶且实际上也是魁蚶的个数;FP为预测为魁蚶但实际上不是魁蚶的个数;FN为预测不是魁蚶但实际上是魁蚶的个数;本研究中的mAP包括mAP@0.5和mAP@0.5:0.95,mAP@0.5是在0.5的IoU阈值下计算的平均精度均值,mAP@0.5:0.95是在0.5~0.95范围内多个不同的IoU阈值下,分别计算各阈值下平均精度均值。mAP越高说明模型在检测方面的性能越优秀。
3.3 改进模型训练
本研究中改进后的DSDC-YOLOv11n模型与原始YOLOv11n模型的精确度、召回率与mAP@0.5随迭代次数变化过程对比如图10所示。在针对模型训练的任务中,DSDC-YOLOv11n模型拟合速度更快,且精确度、召回率与mAP@0.5均优于原始模型。
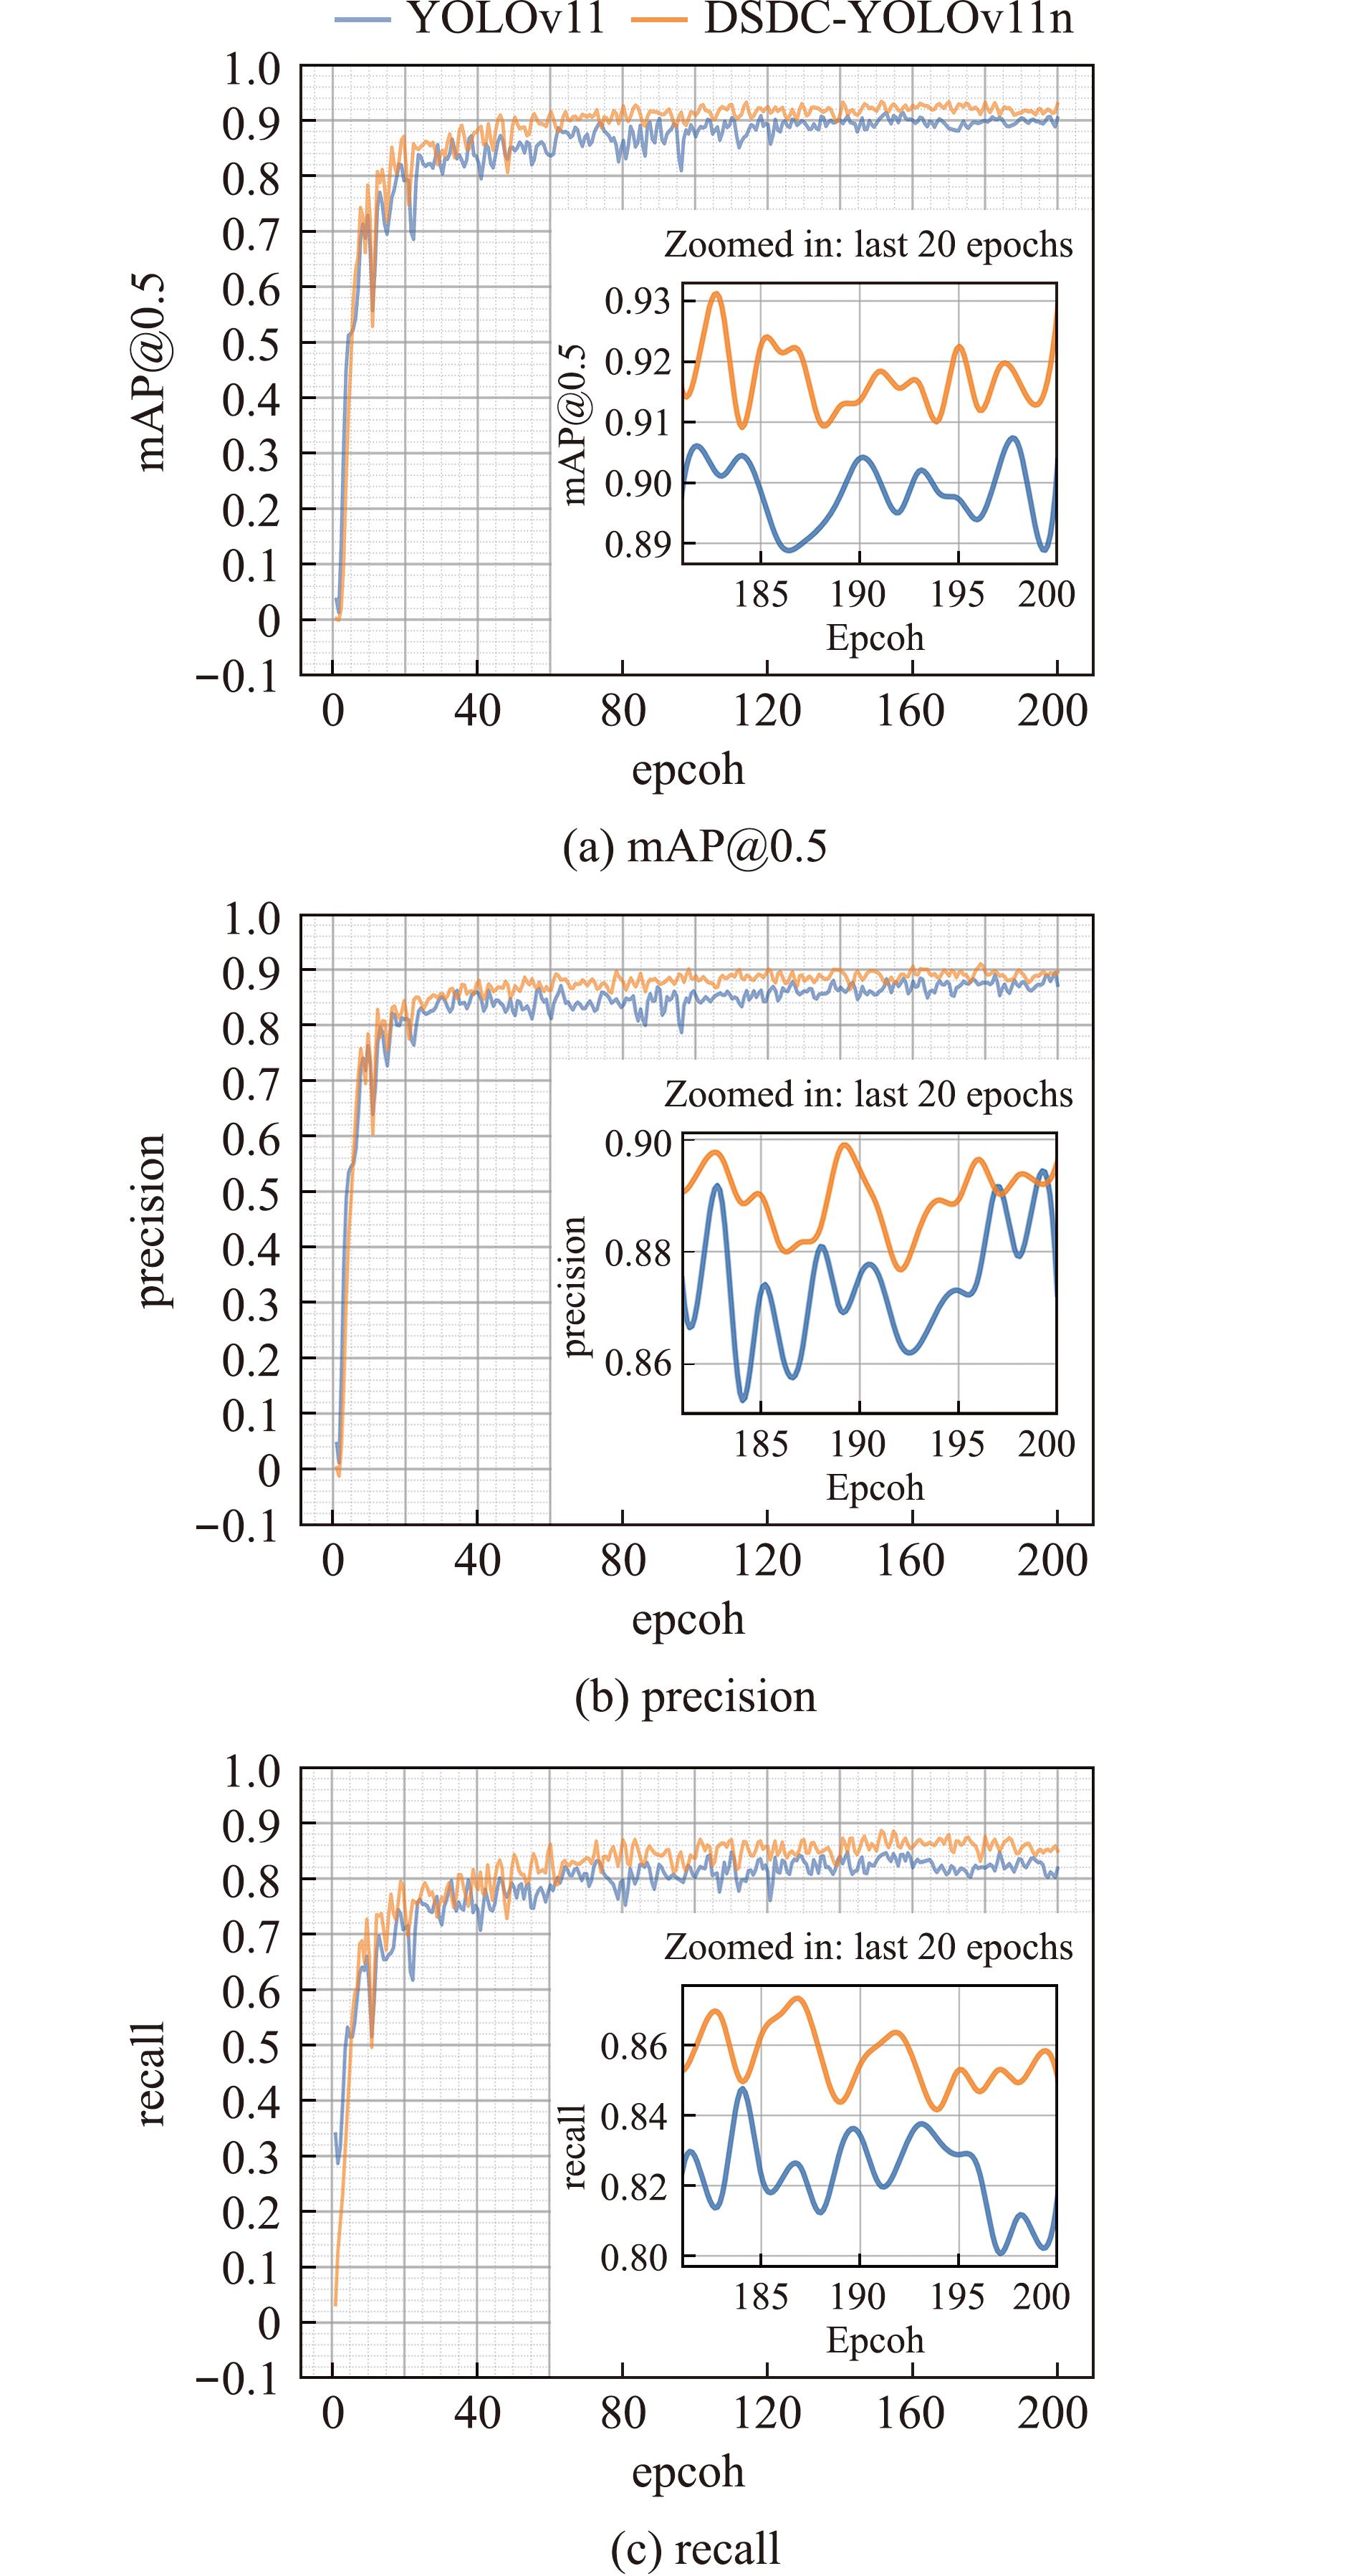
图10 训练过程对比图
Fig.10 Comparison charts of the training process
3.4 消融试验
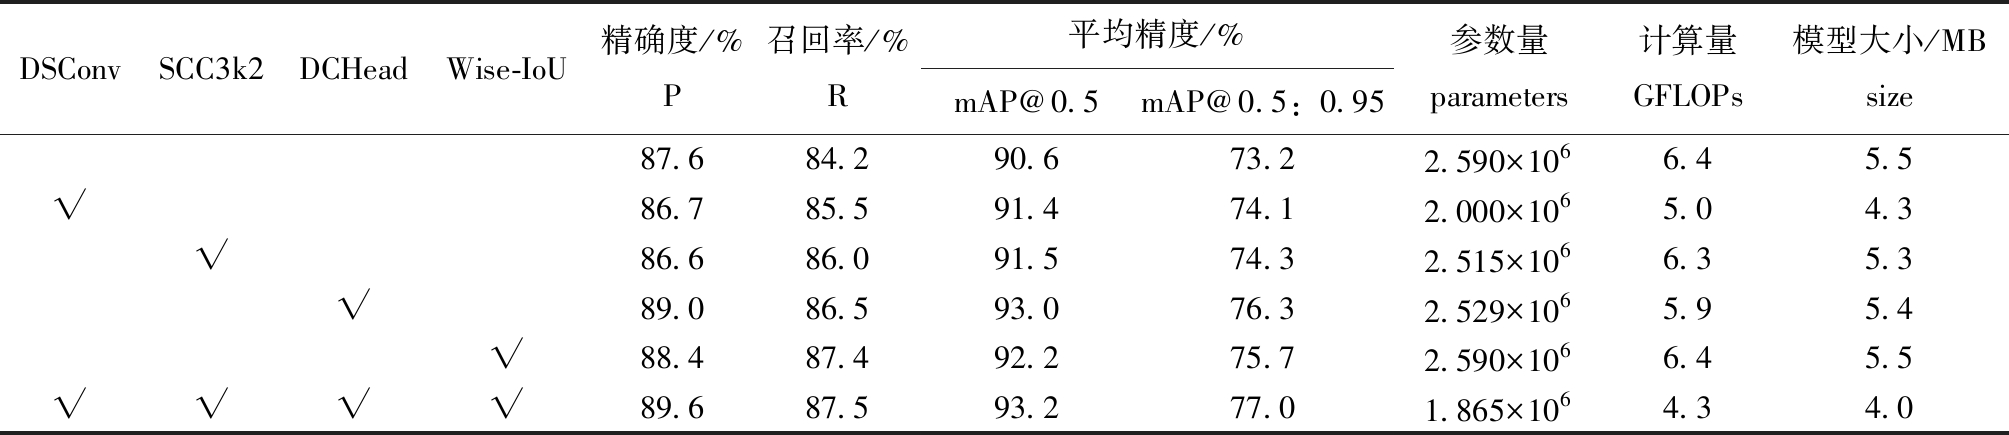
为了清晰地展示DSConv卷积、SCC3k2模块、DCHead检测头与Wise-IoU损失函数对YOLOv11n模型的不同影响,本研究中通过消融试验来分析相同试验环境下不同改进对模型各个评价指标的影响,结果见表1。从表1可见,将主干网络和颈部网络中的卷积模块替换为DSConv模块后,精确度相较于原始模型损失了0.9%,而模型体积减少了1.2 MB、计算量减少了21.9%,参数量下降了约22.7%,在维持模型精确度的基础上减少了大量冗余参数。试验结果表明,引入SCC3k2模块在小幅度减少参数量的同时进一步提高了模型的召回率,较原模型提高了1.8%。DSConv卷积与SCC3k2模块引入后精确度的轻微下降,是特征提取侧重点调整与检测效果平衡优化的结果,未削弱模块有效性,反而通过模型整体的轻量化与综合性能提升验证了模块的合理性。采用DCHead检测头使模型的精确度提高了1.4%、召回率提高了2.3%、平均精度上提高了2.4%。引入Wise-IoU损失函数进一步将模型的召回率提升至87.4%。改进后的DSDC-YOLOv11n在精确度、召回率、平均精度均有显著提升,分别提升了2.0%、3.3%和2.6%,模型的参数量、计算量与体积皆实现了轻量化,分别减少了28.0%、32.8%和27.3%。
表1 消融试验结果
Tab.1 Results of ablation experiments
DSConvSCC3k2DCHeadWise-IoU精确度/%P召回率/%R平均精度/%mAP@0.5mAP@0.5:0.95参数量parameters计算量GFLOPs模型大小/MBsize87.684.290.673.22.590×1066.45.5√86.785.591.474.12.000×1065.04.3√86.686.091.574.32.515×1066.35.3√89.086.593.076.32.529×1065.95.4√88.487.492.275.72.590×1066.45.5√√√√89.687.593.277.01.865×1064.34.0
3.5 改进模型与其他基线模型性能对比试验
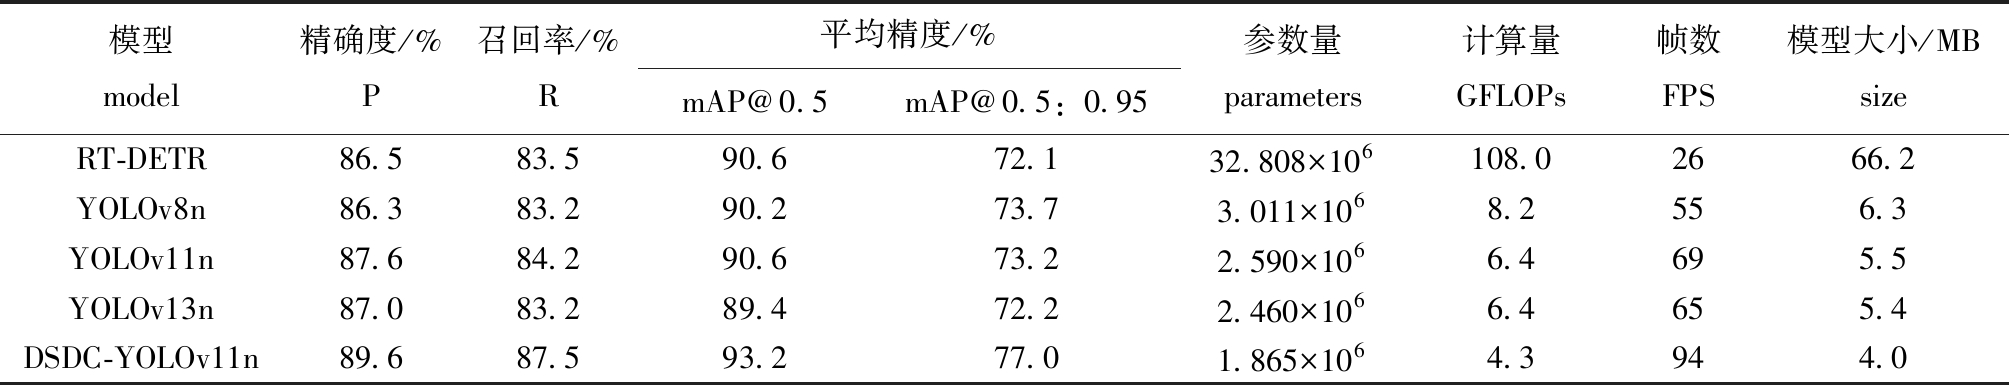
为了验证DSDC-YOLOv11n模型在魁蚶目标检测工作中的性能,本研究在相同试验环境中试验多个模型的性能,如YOLOv8、YOLOv11、YOLOv13[22]和RT-DETR[23]模型。从表2可见,本研究中提出的DSDC-YOLOv11n模型在魁蚶目标检测任务中展现出卓越的综合性能。该模型实现了89.6%的精确度、87.5%的召回率及93.2%的平均精度,各项指标均优于对比模型。在计算效率方面,DSDC-YOLOv11n模型具有明显优势:参数量仅为1.865×10⁶,模型大小仅4.0 MB,均为所有对比模型中的最低值,FPS达到94帧,为对比模型中最高值。与当前主流轻量级检测模型相比,RT-DETR虽在平均精度指标上与YOLOv11n均为90.6%,但其参数量和模型大小显著高于其他模型,不利于在边缘设备部署;YOLO系列轻量模型(YOLOv8n、YOLOv11n、YOLOv13n)在各项性能指标上均低于DSDC-YOLOv11n模型,同时保持着较高的计算量和较大的模型体积。DSDC-YOLOv11n模型在保持高检测精度的同时,成功实现了参数量、计算复杂度与模型体积的协同优化。综合性能与效率分析表明,本研究提出的模型在目标检测精度与计算资源消耗之间取得了良好平衡,不仅检测性能领先,而且具备优异的部署灵活性,适合实时魁蚶检测应用,改进后模型与其他模型检测结果对比如图11所示。图11中依次为RT-DETR、YOLOv8n、YOLOv11n、YOLOv13n、本研究模型,单个魁蚶与多个魁蚶场景下各模型检测效果比较平均,贝类遮挡场景下RT-DETR与YOLOv13n出现明显重检现象,且RT-DETR出现误检现象、YOLOv8n出现漏检现象;魁蚶重叠场景下RT-DETR、YOLOv11n与YOLOv13n出现误检现象且RT-DETR出现重检现象;DSDC-YOLOv11n模型在所有场景中漏检、重检与误检概率最低,进一步验证了模型改进的效果显著。
表2 不同基线模型结果对比
Tab.2 Comparison among results from different baseline models
模型model精确度/%P召回率/%R平均精度/%mAP@0.5mAP@0.5:0.95参数量parameters计算量GFLOPs帧数FPS模型大小/MBsizeRT-DETR86.583.590.672.132.808×106108.02666.2YOLOv8n86.383.290.273.73.011×1068.2556.3YOLOv11n87.684.290.673.22.590×1066.4695.5YOLOv13n87.083.289.472.22.460×1066.4655.4DSDC-YOLOv11n89.687.593.277.01.865×1064.3944.0
表3 不同改进模型结果对比
Tab.3 Comparison among results from different improved models
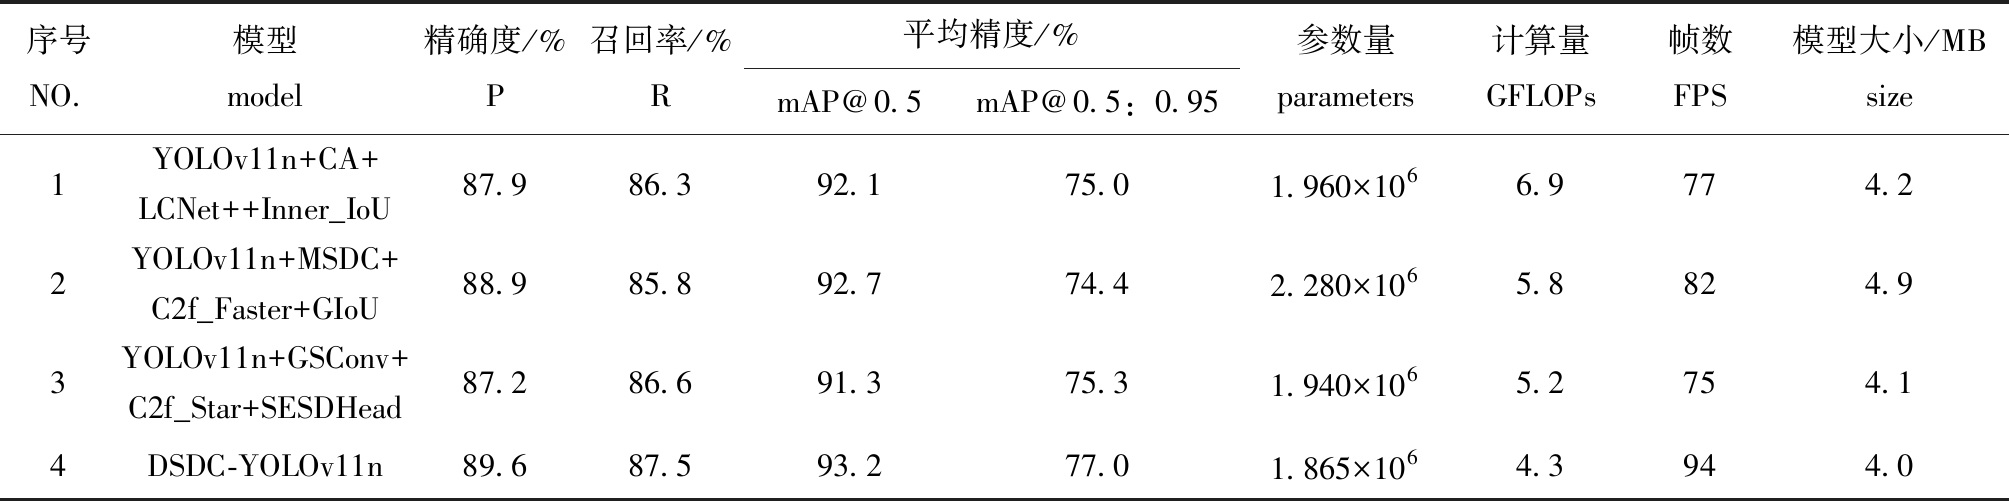
序号NO.模型model精确度/%P召回率/%R平均精度/%mAP@0.5mAP@0.5:0.95参数量parameters计算量GFLOPs帧数FPS模型大小/MBsize1YOLOv11n+CA+LCNet++Inner_IoU87.986.392.175.01.960×1066.9774.22YOLOv11n+MSDC+C2f_Faster+GIoU88.985.892.774.42.280×1065.8824.93YOLOv11n+GSConv+C2f_Star+SESDHead87.286.691.375.31.940×1065.2754.14DSDC-YOLOv11n89.687.593.277.01.865×1064.3944.0
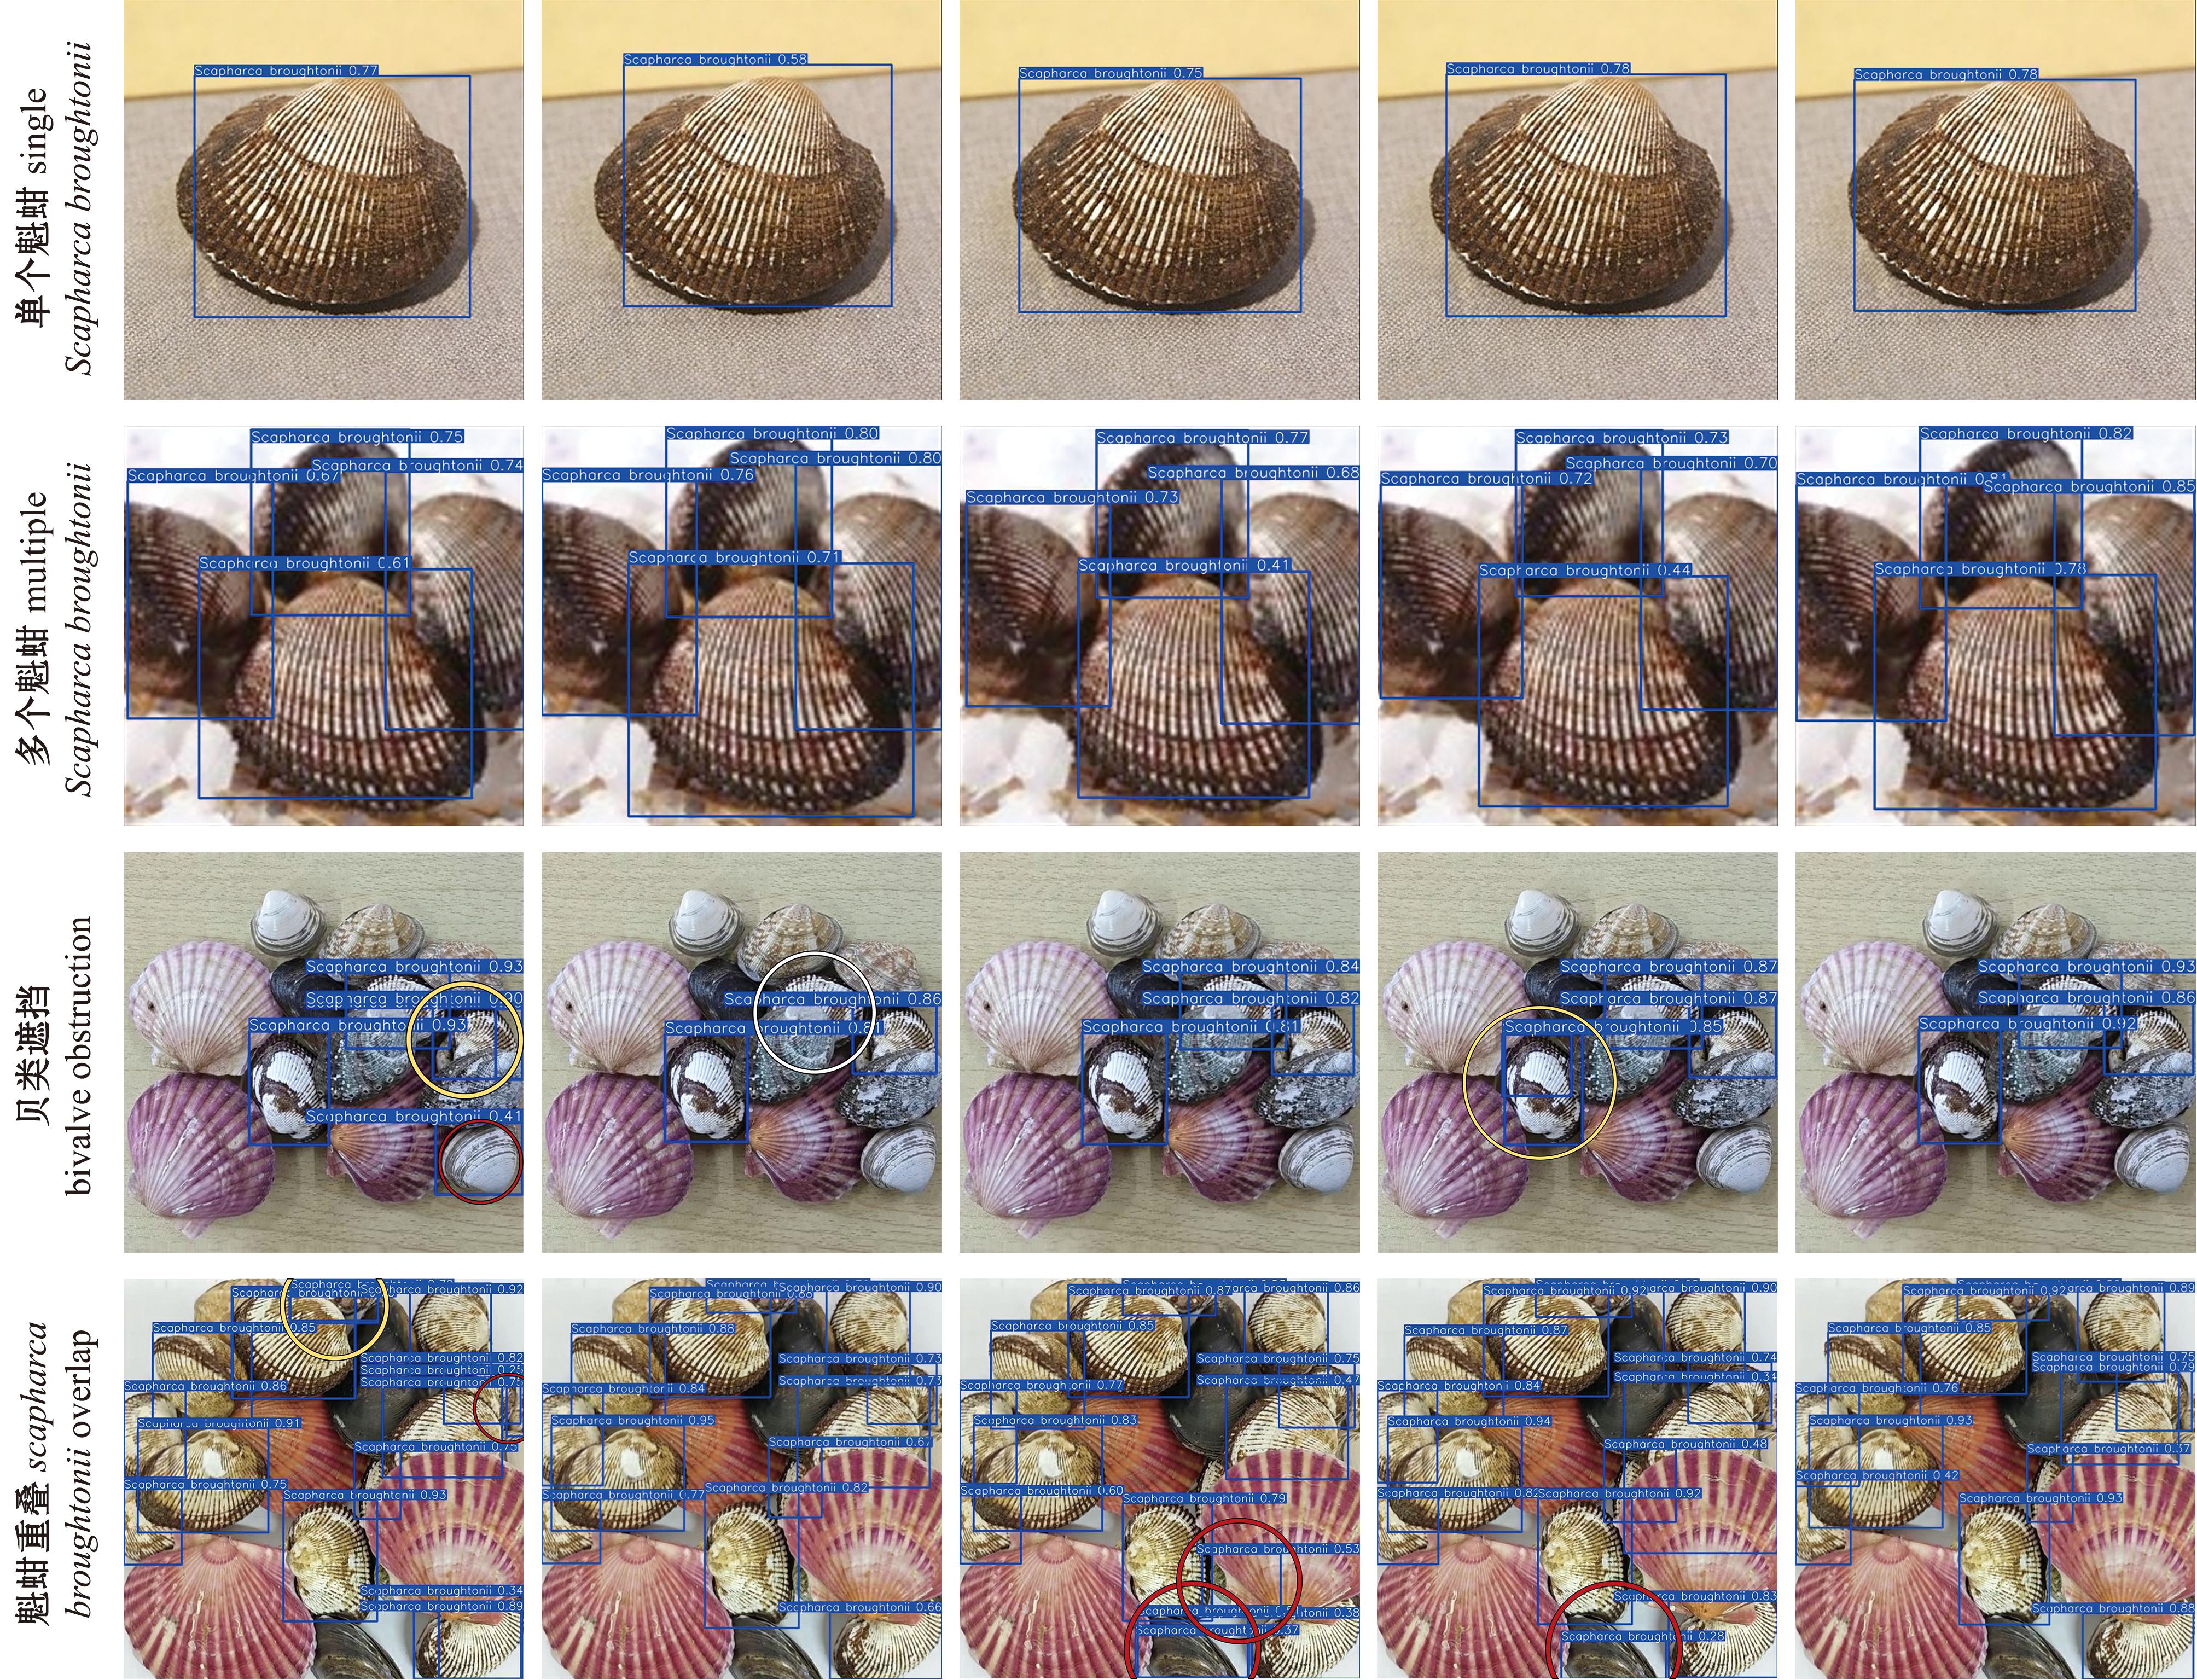
白色圈为漏检;黄色圈为重检;红色圈为误检。White circles—missed detections;Yellow circles—redundant detections;Red circles—false detections.
图11 不同模型检测结果对比
Fig.11 Comparison of detection results among different models
3.6 改进模型与其他改进模型性能对比试验
为进一步验证DSDC-YOLOv11n模型的性能优势,本研究中在前期与基线模型对比的基础上,进行了与多个改进模型的对比试验。试验中所用改进模型从多角度进行改进,试验组1模型集成了CA注意力机制、LCNet主干网络与Inner IoU损失函数;试验组2模型采用了MSDC卷积与GIoU损失函数,并在C2f模块的基础上融合了FasterNet网络中的FasterBlock;试验组3模型引入了GSConv卷积,C2f_Star融合了C2f模块StarNet,SESDHead检测头结合了共享参数机制和SE注意力机制。试验对比组包含了DSDC-YOLOv11n模型所有改进方向,相较于对比试验组模型,DSDC-YOLOv11n模型在精度指标上提升0.7%~2.6%,计算开销降低17.3%~37.6%,推理速度提升14.6%~25.3%。这一结果充分证实DSDC-YOLOv11n通过高效模块设计实现了精度、实时性与资源消耗的最优协同,为轻量级目标检测任务提供了更优解决方案。
3.7 边缘设备部署试验
为验证DSDC-YOLOv11n模型的边缘设备部署能力,采用NVIDIA Jetson Orin Nano 4 GB进行部署试验,如图12所示,试验结果见表4。将改进后模型训练得到的权重文件导入边缘设备后,在FP16TensorRT加速模式下进行目标检测工作,显示屏能准确框选出魁蚶目标,边缘设备上的FPS达到30帧,对比原模型提升了36.3%,证明本研究提出的DSDC-YOLOv11n模型具有良好的边缘设备部署能力,在工程实践层面展现出显著的应用潜力。
表4 部署运行结果
Tab.4 Result of the deployment
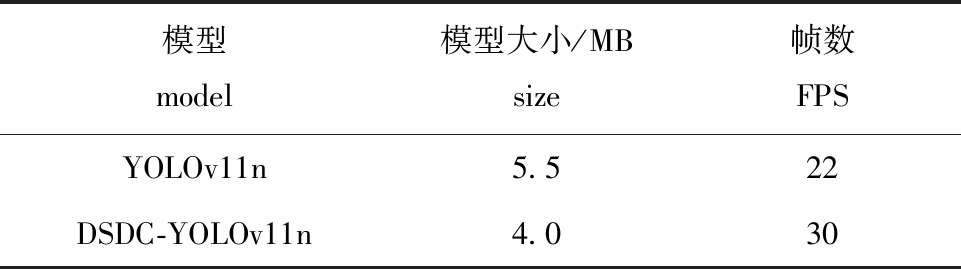
模型model模型大小/MBsize帧数FPSYOLOv11n5.522DSDC-YOLOv11n4.030
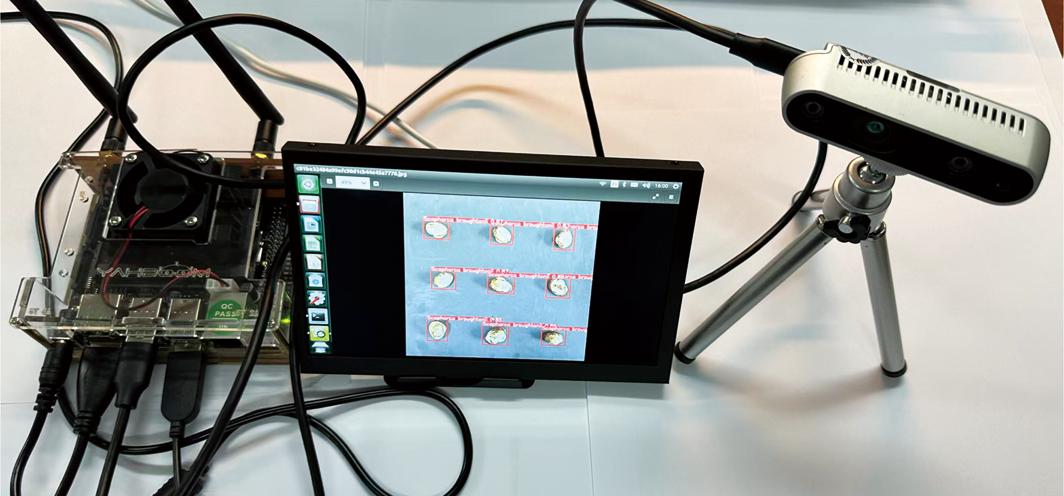
图12 边缘设备部署
Fig.12 Edge device deployment
4 讨论
4.1 改进卷积模块对模型检测性能的影响
采用轻量化的卷积模块是模型轻量化的常用方法之一,优化模型中的卷积模块能在保持模型精度的同时降低模型的运算成本。罗斌等[24]提出了GEB-YOLOv8n模型,通过引入GSConv卷积实现模型大幅度轻量化,GEB-YOLOv8n模型平均精度达到91.8%,模型参数量与体积对比原模型分别减少了42.8%和40.7%。Ding等[25]提出的ACS-YOLO模型采用Adown模块降低计算复杂度并增强缺陷特征提取,模型参数量下降31.5%且体积减少41.4%。本研究中通过引入DSConv模块和融合SCConv组成SCC3k2模块的方法实现卷积模块轻量化,试验结果表明,引入轻量化卷积模块后模型的识别能力有所提升,并实现了模型轻量化。
4.2 改进检测头对模型检测性能的影响
原始检测头在小目标和密集场景中特征融合不足,导致定位精度低和漏检率高;改进检测头通过引入动态特征融合机制和轻量级注意力模块,可显著提升模型对小目标的检测能力。An等[26]基于共享参数优化策略设计了轻量级DEGC检测头,提出CHCG-YOLO模型相比原YOLOv11n模型参数量减少30.7%、模型体积仅4.0 MB且平均精度对比原模型提升1%。Dang等[27]利用MSCH模块共享卷积层减少检测头中的参数数量,保持精确度的同时参数量减少了40%。Li等[28]集成了轻量化的LSCD检测头,提升了模型对小目标的检测能力,提出的SGL-YOLO模型参数减少了45.2%。本研究在原有检测头基础上结合动态卷积Dynamic Conv的设计思路设计了具有动态参数生成机制的DCHead检测头,结果表明,DCHead检测头在维持参数量、计算量和模型体积不上涨的情况下提高了模型的检测精度。
4.3 改进损失函数对模型检测性能的影响
原始损失函数对小目标检测和样本质量不平衡问题处理不足,导致复杂场景下精度受限;改进损失函数通过优化权重分配和引入针对性策略,可显著提升小目标检测能力与密集场景鲁棒性。方会敏等[29]提出一种针对顶芽识别的Shape-NWD-IoU损失函数,有效减少了模型参数量和计算成本,同时提高了顶芽检测精度。Wang等[30]采用Fast-IoU优化损失函数,提出的LE-YOLO模型对比原YOLOv8n模型平均精度提升了5.6%。本研究中采用Wise-IoU处理样本质量平衡问题,试验结果表明,引入Wise-IoU改进模型损失函数有效提升了模型的检测能力。
5 结论
1)本研究中提出一种基于改进的YOLOv11n魁蚶目标检测模型DSDC-YOLOv11n,该模型在魁蚶数据集上的精确度达到89.6%、召回率达到87.5%、平均精度达到93.2%,结果证明,该模型能够满足对魁蚶目标的智能检测。
2)该模型在主干网络和颈部网络中引入深度可分离卷积DSConv降低网络参数量,在主干网络中引入SCConv重构C3k2模块,组成特征提取模块SCC3k2,进一步减少参数量并提升模型特征提取能力,在头部网络中引入动态卷积检测头DCHead提高模型识别精度,采用损失函数Wise-IoU加快模型收敛速度,进一步提升了模型的识别能力。
3)本研究中提出的DSDC-YOLOv11n模型的精确度、召回率与平均精度在魁蚶识别工作中显著优于YOLOv8n、YOLOv11n、YOLOv13n、RT-DETR等模型,且在参数量、计算量与模型体积方面更加轻量化,证明了DSDC-YOLOv11n模型在魁蚶目标检测上的综合性优势,同时将模型在边缘设备上进行部署,验证了模型在边缘设备中实现目标检测的能力。
[1] 谢玺,滕炜鸣,李华琳,等.魁蚶生物学与增养殖技术研究进展[J].大连海洋大学学报,2020,35(6):930-938.XIE X,TENG W M,LI H L,et al.Advances in biology and breeding technology of ark shell Scapharca broughtonii:a review[J].Journal of Dalian Ocean University,2020,35(6):930-938.(in Chinese)
[2] 信炳龙,吴彪,周丽青,等.4个不同地理群体魁蚶主要可量性状特征分析[J].海洋渔业,2021,43(6):652-660.XIN B L,WU B,ZHOU L Q,et al.Characters of main measurable traits of Scapharca broughtonii in four different geographical populations[J].Marine Fisheries,2021,43(6):652-660.(in Chinese)
[3] 薛素燕,王金叶,李加琦,等.温度对魁蚶能量代谢及抗氧化酶活性的影响[J].水产学报,2019,43(3):573-583.XUE S Y,WANG J Y,LI J Q,et al.Effects of temperature on energy metabolism and antioxidant enzyme activities of Scapharca broughtonii[J].Journal of Fisheries of China,2019,43(3):573-583.(in Chinese)
[4] MENDOZA Y,FREITES L,LODEIROS CJ,et al.Evaluation of biological and economical aspects of the culture of the scallop Lyropecten (Nodipecten) Nodosus in suspended and bottom culture[J].Aquaculture,2003,221(1/2/3/4):207-219.
[5] 李响,高国栋,张为,等.基于改进YOLOv8的扇贝破损检测模型[J].大连海洋大学学报,2025,40(4):695-704.LI X,GAO G D,ZHANG W,et al.Scallop damage detection model based on an improved YOLOv8 method[J].Journal of Dalian Ocean University,2025,40(4):695-704.(in Chinese)
[6] VO T T E,KO H,HUH J H,et al.Overview of smart aquaculture system:focusing on applications of machine learning and computer vision[J].Electronics,2021,10(22):2882.
[7] LI S S,LI C,YANG Y,et al.Underwater scallop recognition algorithm using improved YOLOv5[J].Aquacultural Engineering,2022,98:102273.
[8] 张铮,鲁祥,胡庆松.基于图像增强与GC-YOLO v5s的水下环境河蟹识别轻量化模型研究[J].农业机械学报,2024,55(11):124-131,374.ZHANG Z,LU X,HU Q S.Lightweight model for river crab detection based on image enhancement and improved YOLO v5s[J].Transactions of the Chinese Society for Agricultural Machinery,2024,55(11):124-131,374.(in Chinese)
[9] LIU C J,ZHONG L,WANG J,et al.Grain-YOLO:an improved lightweight YOLO v8 and its Android deployment for rice grains detection[J].Computers and Electronics in Agriculture,2025,237:110757.
[10] DENG X,HUANG T L,WANG W J,et al.SE-YOLO:a sobel-enhanced framework for high-accuracy,lightweight real-time tomato detection with edge deployment capability[J].Computers and Electronics in Agriculture,2025,239:110973.
[11] KHANAM R,HUSSAIN M.YOLOv11:an overview of the key architectural enhancements[EB/OL].2024:arXiv:2410.17725.https://arxiv.org/abs/2410.17725
[12] CHOLLET F.Xception:deep learning with depthwise separable convolutions[C]//2017 IEEE Conference on Computer Vision and Pattern Recognition (CVPR).July 21-26,2017,Honolulu,HI,USA.IEEE,2017:1800-1807.
[13] LI Y H,HUANG Y R,TAO Q.Improving real-time object detection in Internet-of-Things smart city traffic with YOLOv8-DSAF method[J].Scientific Reports,2024,14:17235.
[14] LI J F,WEN Y,HE L H.SCConv:spatial and channel reconstruction convolution for feature redundancy[C]//2023 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR).June 17-24,2023,Vancouver,BC,Canada.IEEE,2023:6153-6162.
[15] PENG X L,ZENG L S,ZHU W Z,et al.A small object detection model for improved YOLOv8 for UAV aerial photography scenarios[C]//2024 5th International Seminar on Artificial Intelligence,Networking and Information Technology (AINIT).March 29-31,2024,Nanjing,China.IEEE,2024:2099-2104.
[16] 刘罡,侯恩翔,黄孙港,等.多尺度特征融合增强的行人翻越护栏检测[J].电子测量技术,2024,47(14):127-138.LIU G,HOU E X,HUANG S G,et al.Multi scale feature fusion enhanced pedestrian crossing guardrail detection[J].Electronic Measurement Technology,2024,47(14):127-138.(in Chinese)
[17] CHEN Y P,DAI X Y,LIU M C,et al.Dynamic convolution:attention over convolution kernels[C]//2020 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR).June 13-19,2020.Seattle,WA,USA.IEEE,2020:11027-11036.
[18] ZHANG Y K,ZHANG J,WANG Q,et al.DyNet:dynamic convolution for accelerating convolutional neural networks[EB/OL].2020:arXiv:2004.10694.https://arxiv.org/abs/2004.10694
[19] WU Q L,CHEN X F,SHANG S Y,et al.A method for small object contamination detection of Lentinula Edodes logs integrating SPD-conv and structural reparameterization[C]//Green,Pervasive,and Cloud Computing.Singapore:Springer,2024:30-46.
[20] 罗亮,郎霄,祖国庆,等.一种基于改进YOLOv8n的气缸套缺陷检测方法[J].中国机械工程,2025,36(5):1054-1064.LUO L,LANG X,ZU G Q,et al.A cylinder liner defect detection method based on improved YOLOv8n[J].China Mechanical Engineering,2025,36(5):1054-1064.(in Chinese)
[21] TONG Z J,CHEN Y H,XU Z W,et al.Wise-IoU:bounding box regression loss with dynamic focusing mechanism[EB/OL].2023:arXiv:2301.10051.https://arxiv.org/abs/2301.10051
[22] LEI M Q,LI S Q,WU Y H,et al.YOLOv13:real-time object detection with hypergraph-enhanced adaptive visual perception[EB/OL].2025:arXiv:2506.17733.https://arxiv.org/abs/2506.17733
[23] ZHAO Y A,LV W Y,XU S L,et al.DETRs beat YOLOs on real-time object detection[C]//2024 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR).June 16-22,2024,Seattle,WA,USA.IEEE,2024:16965-16974.
[24] 罗斌,马乐意,周亚男,等.基于GEB-YOLO v8n的烟草蚜虫识别与计数方法[J].农业机械学报,2026,57(1):159-168,179.LUO B,MA L Y,ZHOU Y N,et al.Tobacco aphid identification and counting method based on GEB-YOLO v8n[J].Transactions of the Chinese Society for Agricultural Machinery,2026,57(1):159-168,179.(in Chinese)
[25] DING L,XU H,DU P,et al.ACS-YOLO:a lightweight bearing surface defect detection algorithm[J].Journal of Engineering and Applied Science,2025,72(1):228.
[26] AN X J,SUN L Y,ZHAO Y J,et al.CHCG-YOLO:a lightweight model for fruit recognition[J].Journal of Food Measurement and Characterization,2026,20(2):1971-1985.
[27] DANG L X,LI Z,LI S L,et al.Effective plug-and-play lightweight modules for YOLO series models[J].The Journal of Supercomputing,2025,81(3):493.
[28] LI M H,PANG H L,JIANG C H.SGL-YOLO:Lightweight underwater object detection algorithm based on feature fusion[J].Signal,Image and Video Processing,2025,19(16):1372.
[29] 方会敏,徐全旺,陈学庚,等.基于DFR-SN-YOLO的棉花顶芽识别方法[J].农业工程学报,2025,41(17):162-174.FANG H M,XU Q W,CHEN X G,et al.Cotton top bud recognition method based on DFR-SN-YOLO[J].Transactions of the Chinese Society of Agricultural Engineering,2025,41(17):162-174.(in Chinese)
[30] WANG J P,HUANG Z L,DONG Y,et al.LE-YOLO:a lightweight and effective YOLO model for remote sensing image object detection[J].Journal of Real-Time Image Processing,2026,23:27.
